Система распознавания речи от Meta попала в рейтинг лучших изобретений TIME
Система распознавания речи Omnilingual ASR от Meta, поддерживающая более 1600 языков, вошла в список лучших изобретений 2026 года по версии журнала TIME.

Система распознавания речи Omnilingual ASR от Meta, поддерживающая более 1600 языков, вошла в список лучших изобретений 2026 года по версии журнала TIME.

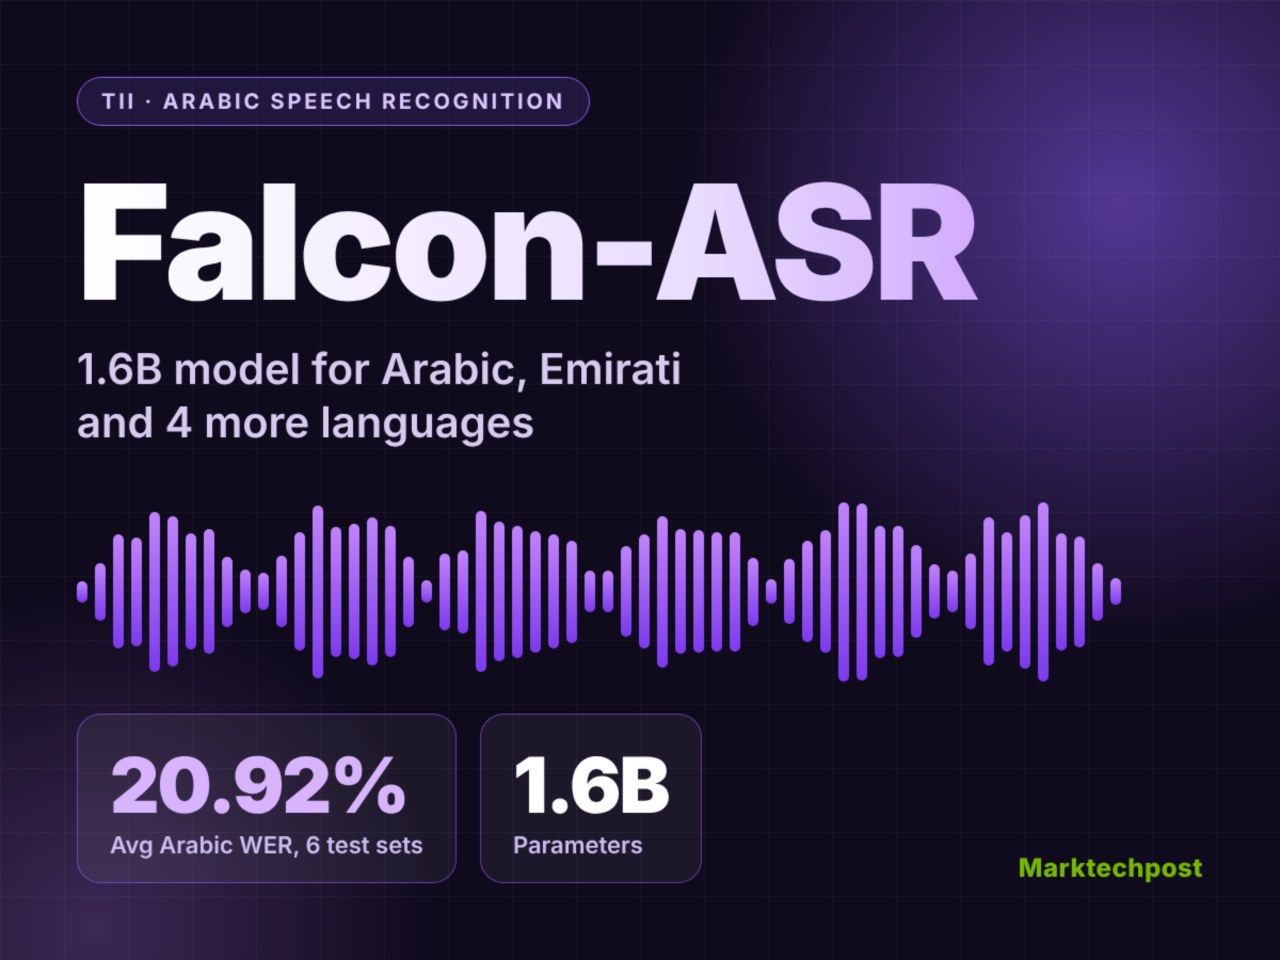
Институт TII представил модель Falcon-ASR с 1,6 миллиарда параметров для распознавания арабской речи, показавшую 20,92% WER во внутренних тестах.

Компания Willow Care Inc. выбрала CoreWeave для поддержки инфраструктуры обучения ИИ, стремясь к полному отказу от клавиатур в пользу голосового ввода в течение двух лет.

Компания Anthropic запустила программу добровольного сбора голосовых данных для улучшения систем распознавания речи и ответов в своих моделях ИИ.

Microsoft представила три модели для работы с голосом, включая лидера рейтинга потоковой транскрипции и два инструмента для синтеза речи с поддержкой клонирования голоса.

Сервис МТС для слабослышащих пользователей обеспечил проведение около 500 тыс. телефонных разговоров за первые полгода работы.
Шведский стартап Klang привлек €1,32 миллиона на международную экспансию и представил открытую модель для распознавания шведской речи, работающую на обычном оборудовании.

Сервис МТС для слабослышащих абонентов обеспечил проведение около 500 тыс. разговоров за полгода работы.
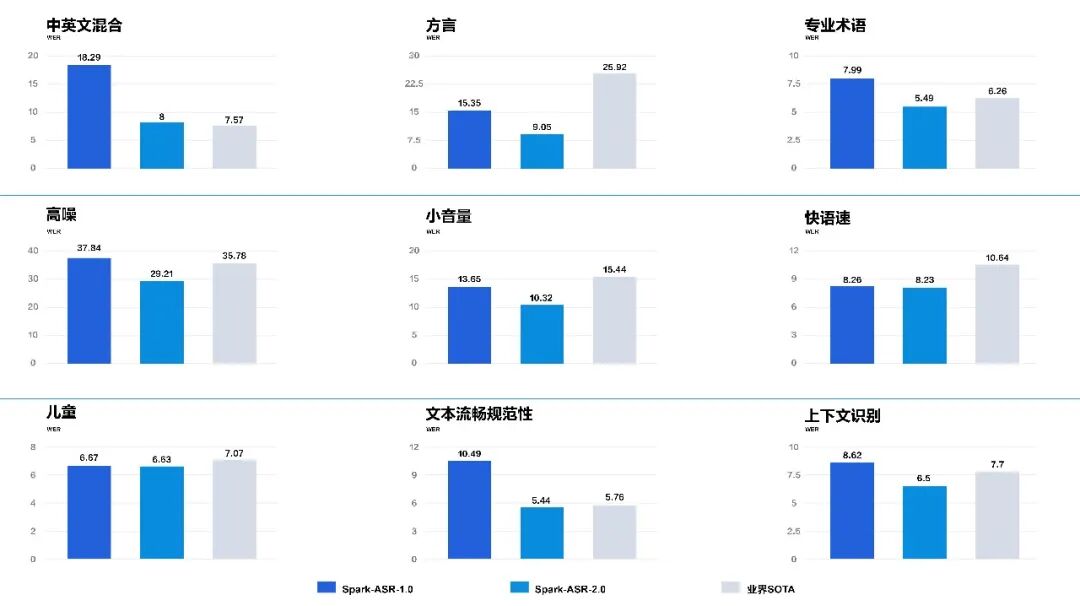
Компания iFlytek представила модель распознавания речи Spark-ASR-2.0, которая повышает точность обработки звука в сложных условиях при росте затрат на вычисления всего на 10 процентов.

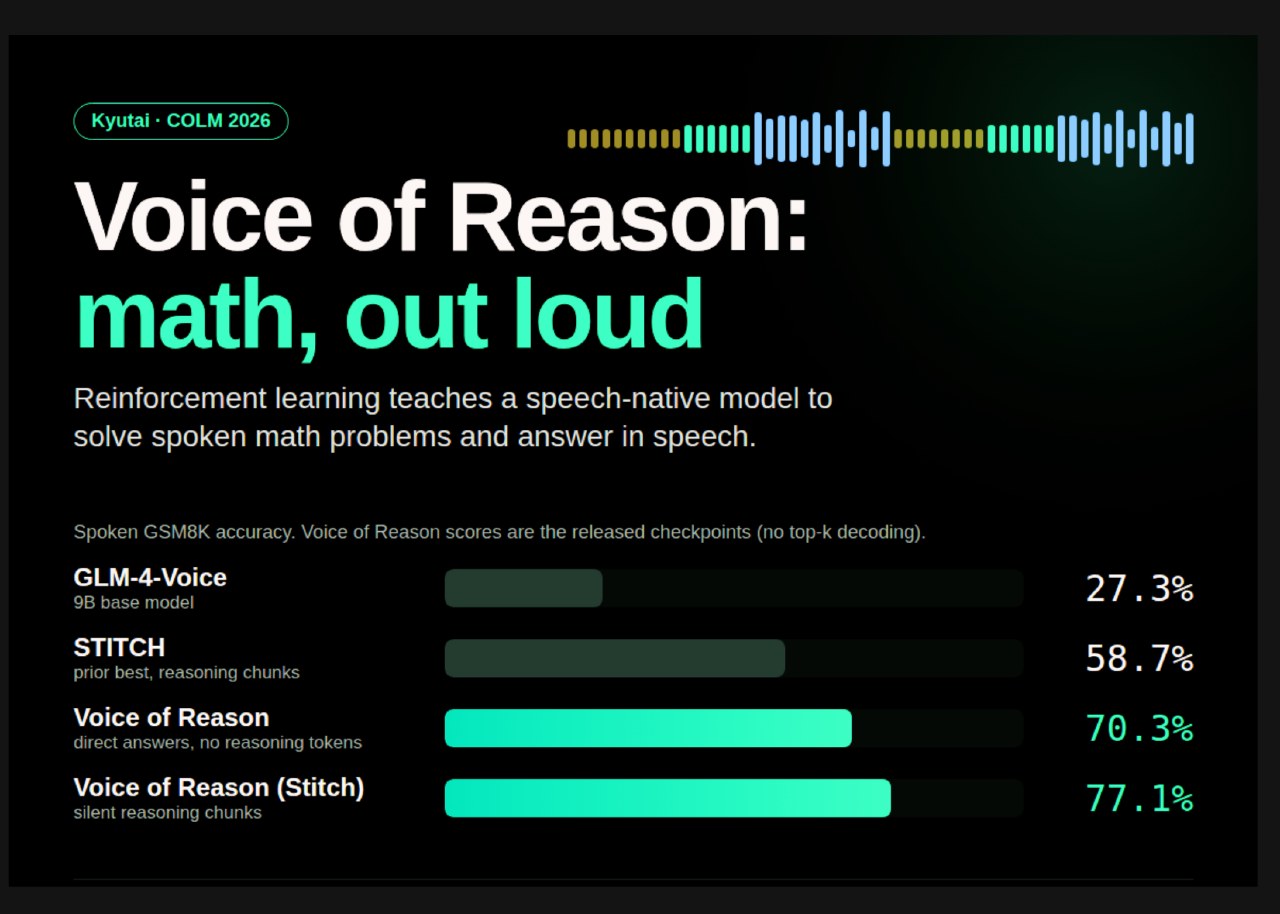
Лаборатория Kyutai выпустила модель Voice of Reason, которая использует обучение с подкреплением для решения математических задач голосом, достигая точности 77,1% на тесте GSM8K.

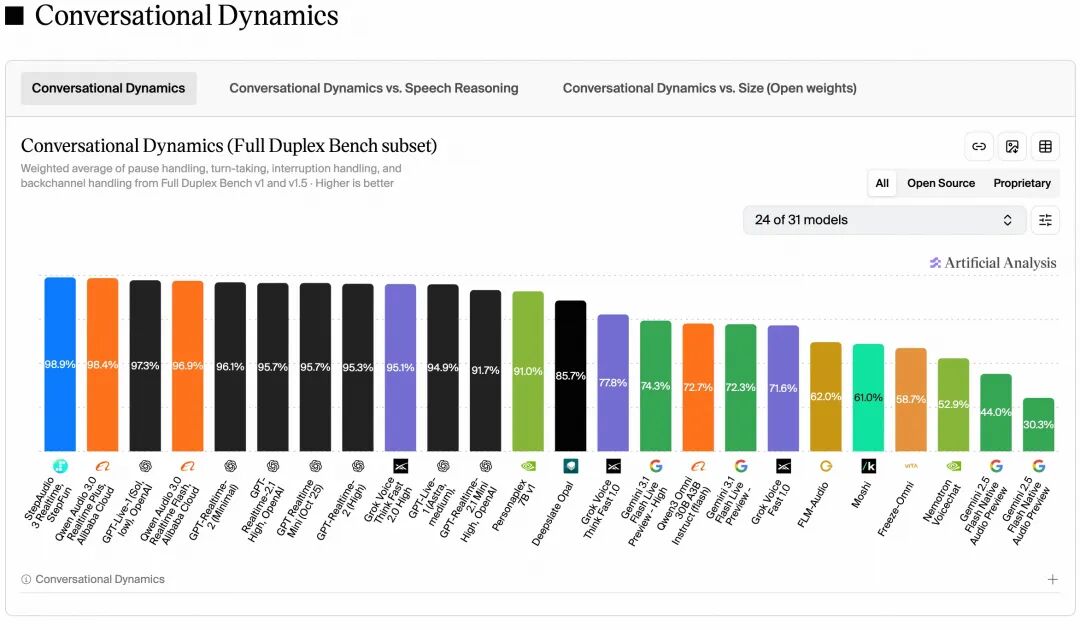
Компания StepStar выпустила серию моделей StepAudio 3, которые заняли первые места в мировых рейтингах по качеству распознавания речи и генерации аудио.

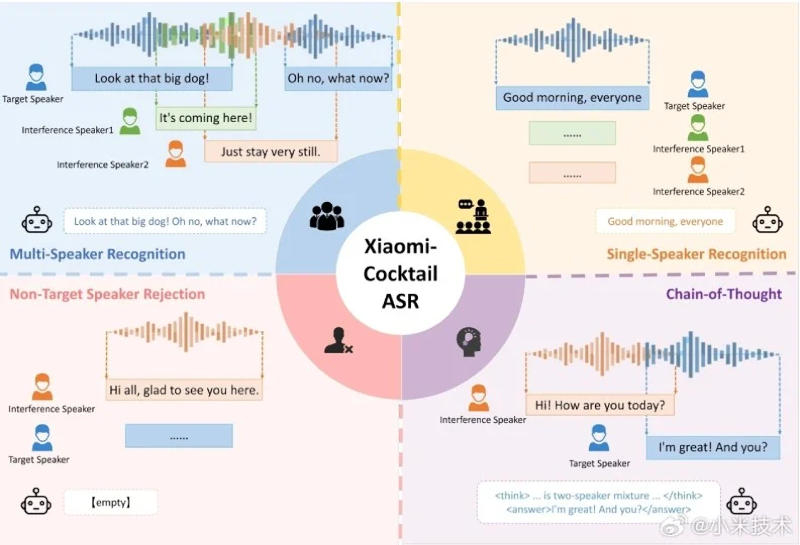
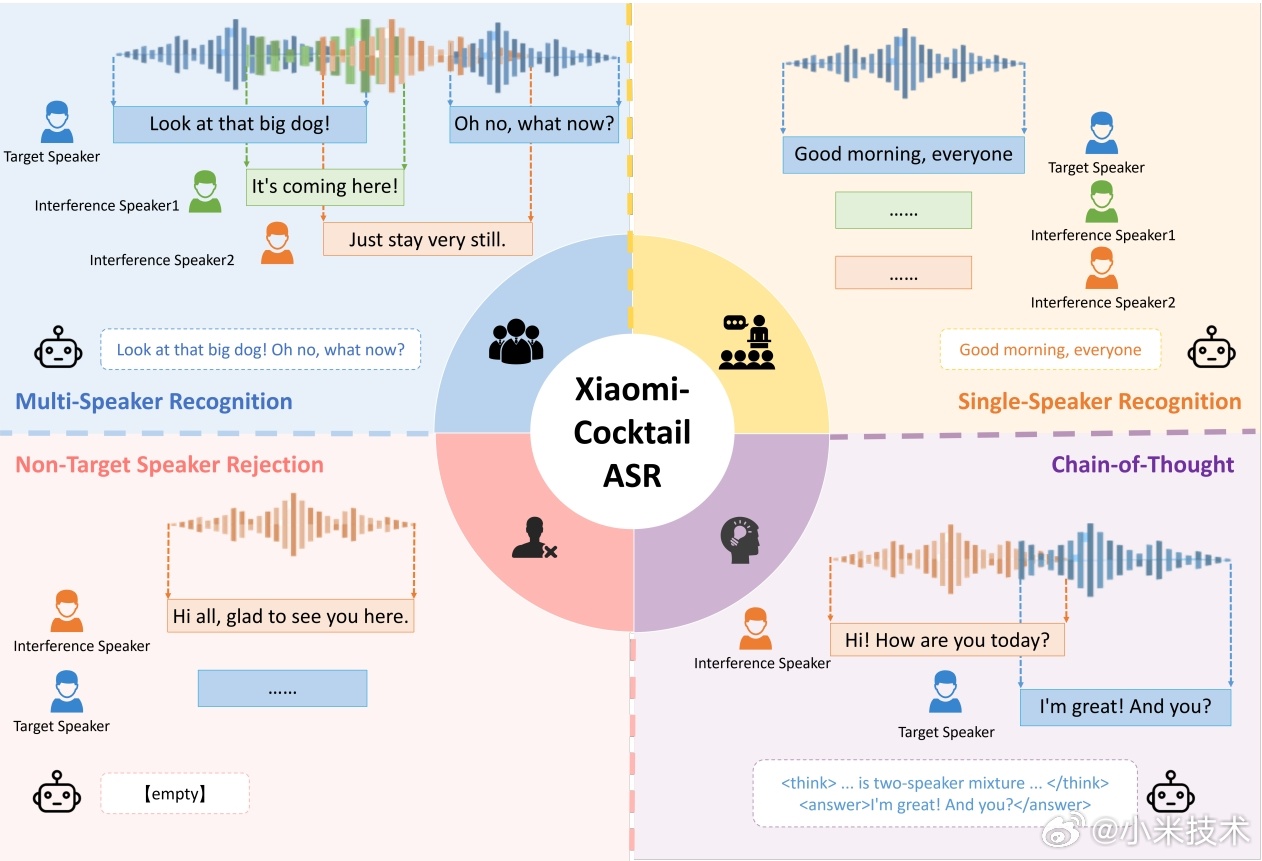
Компания Xiaomi представила открытую ИИ-модель CocktailASR-1, предназначенную для выделения и расшифровки речи конкретного человека в условиях многоголосия.

Компания Xiaomi представила модель CocktailASR-1 с открытым кодом, которая позволяет выделять голос конкретного человека в условиях многоголосия с помощью архитектуры LLM.

Исследователи «Криптонита» создали модель определения языка, которая работает в 10 раз быстрее и в 5 раз легче исходной нейросети с 1 миллиардом параметров.

Компания «Криптонит» разработала компактную модель определения языка речи, которая работает в 10 раз быстрее и в 5 раз легче аналога.