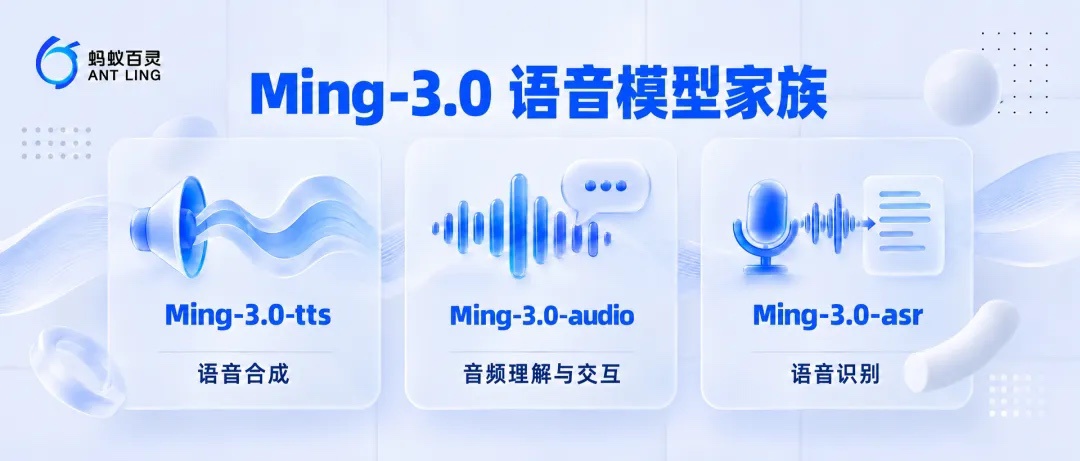
Компания Ant Group открыла исходный код серии речевых моделей Ming-3.0. В линейку вошли пять моделей, разделенных на три функциональных направления: синтез речи, аудиоанализ и распознавание звука.
Серия Ming-3.0-tts поддерживает функцию Voice Design, позволяющую настраивать тембр голоса через текстовое описание или эталонный аудиофайл. Режим режиссера дает возможность задавать эмоциональную окраску, расставлять акценты и регулировать темп речи.
Модели Ming-3.0-audio-flash и tiny предназначены для работы с длинными аудиозаписями. Они выполняют транскрибацию, суммаризацию и анализ контента, сохраняя при этом данные об участниках диалога и окружающем фоне.
Модель Ming-3.0-asr-tiny обучена на корпусе данных, включающем путунхуа, английский язык и диалекты. Использование контекстной информации и списков ключевых слов позволяет повысить точность распознавания в бизнес-задачах.
Технологии уже внедрены в сервисы компании, включая приложение Afu, системы клонирования голоса для медицины и офисные инструменты. Разработчикам доступны API для работы с моделями через платформу Ling Studio.