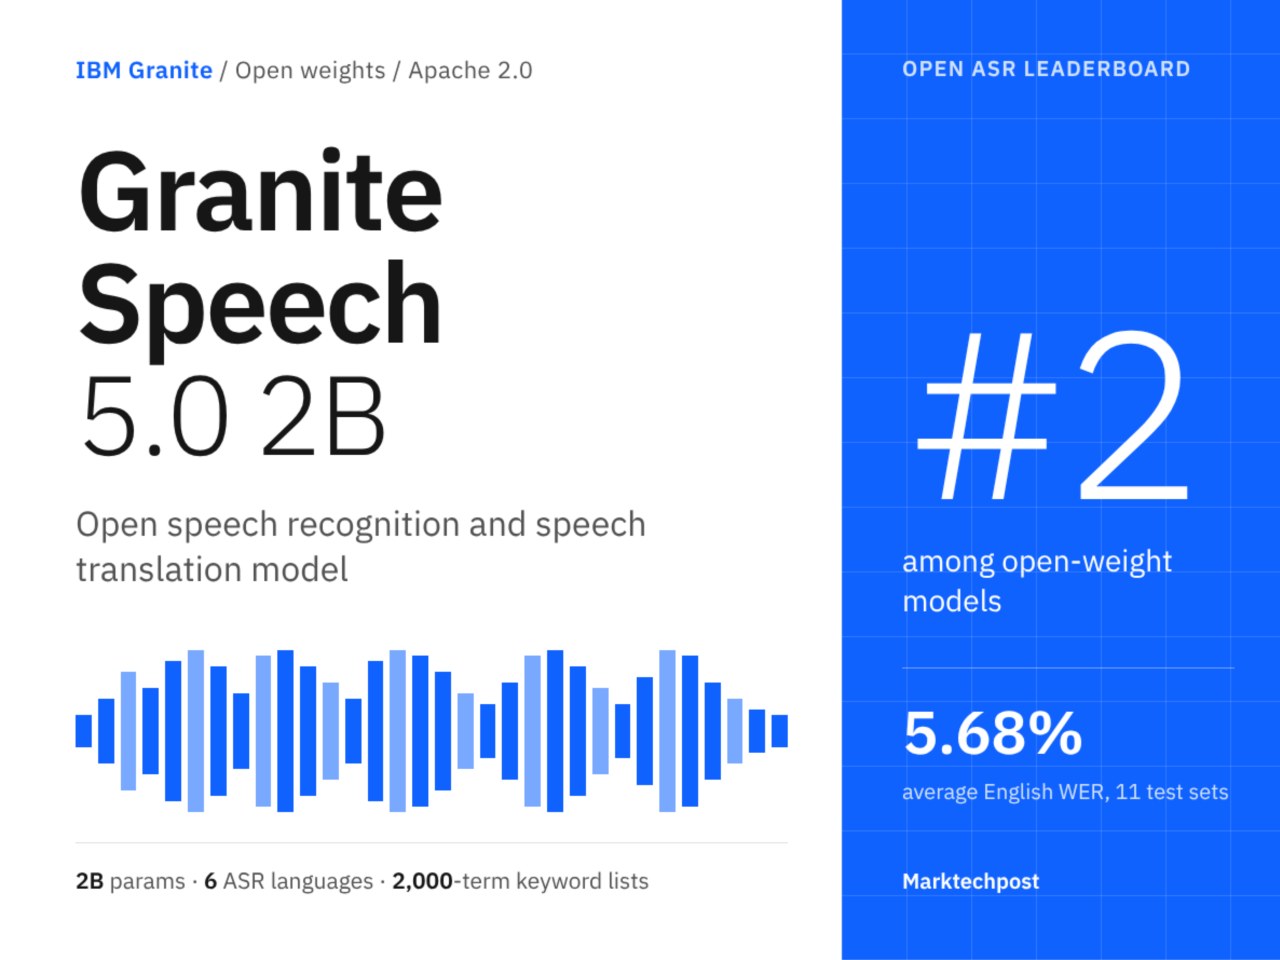
Компания IBM представила модель Granite Speech 5.0 2B для транскрибации и перевода речи. Архитектура включает 16-блочный Conformer-энкодер, 2-слойный q-former для обработки акустических эмбеддингов и LLM на базе granite-4.0-1b-base, дообученную с помощью LoRA и расширенную до 16 000 позиций через YaRN.
Обучение заняло 40 дней на 8 графических процессорах H100 с использованием 390 000 часов аудиоданных. На Open ASR Leaderboard модель показала средний уровень ошибок (WER) в английском языке 5,68%. Результаты варьируются от 0,99% на LibriSpeech Clean до 13,79% на закрытых разговорных наборах данных.
В мультиязычных задачах WER составил 2,60% для португальского и 3,50% для испанского языков. Показатель BLEU для перевода на английский достиг 53,6 для португальского и 40,1 для немецкого. Функция учета ключевых слов повысила показатель F1 на наборе Earnings-22 с 67,2 до 90,1.
Обновление Granite Speech 5.0 Turbo CTC с размером 470M теперь поддерживает 7 языков и демонстрирует пропускную способность 19 870 RTFx. Версия Granite Speech 4.1 2B Plus показала снижение WER на длинных аудио с 13,53 до 10,22, а также уменьшение среднего сдвига временных меток с 210,86 до 98,54.
Модель совместима с фреймворками Transformers, vLLM, llama.cpp и mlx-audio. Для формата GGUF разработчики рекомендуют квантование Q8_0, так как использование более низких битов может привести к потере точности при обработке аудиозаписей длительностью более одной минуты.