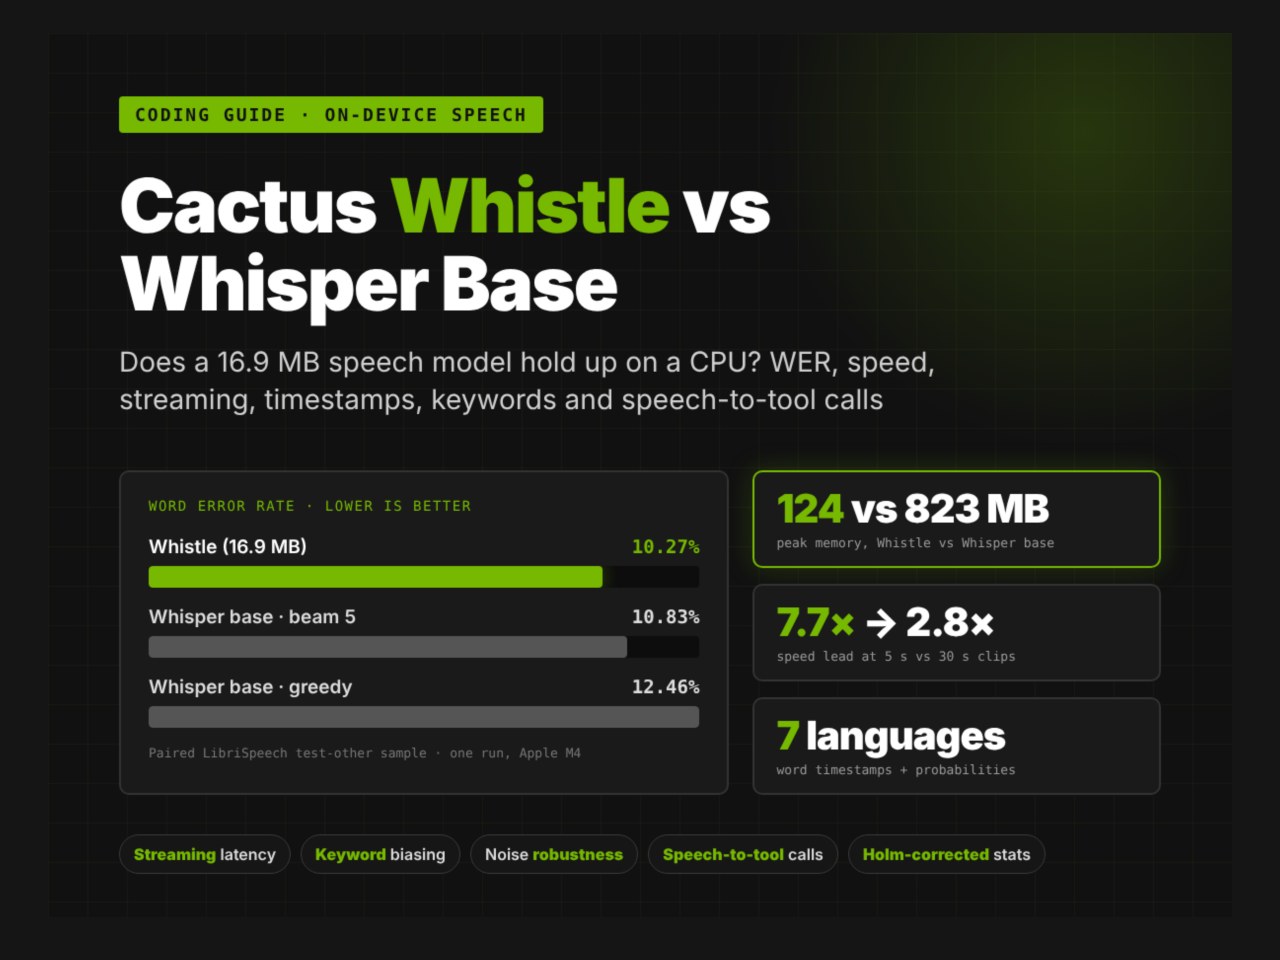
Исследование посвящено оценке работы модели распознавания речи Whistle с весами 16,9 МБ. Процесс тестирования включает установку пакета cactus-needle версии 3.2.0 с фиксацией ревизий весов и движка в репозиториях Hugging Face для обеспечения воспроизводимости результатов.
Для тестов использовался набор данных LibriSpeech, из которого было отобрано по 300 фрагментов для каждого сплита. Из выборки исключили аудиозаписи длиннее 30 секунд, что соответствует ограничению окна обработки Whistle. Для сравнения 100 фрагментов из test-other и 60 из test-clean прогнали через модель Whisper.
Методология опирается на использование случайной выборки и доверительных интервалов для кластеров спикеров. Разница в показателях считается статистически значимой, если 95-процентный интервал не включает ноль, а скорректированное по Холму p-значение составляет менее 0,05.
Бенчмарки проводились на процессоре. Система фиксирует время до первого токена, временные метки слов и вероятностные оценки. Фреймворк тестирования поддерживает автоматические повторные запросы к API и приведение аудио к частоте 16 кГц.