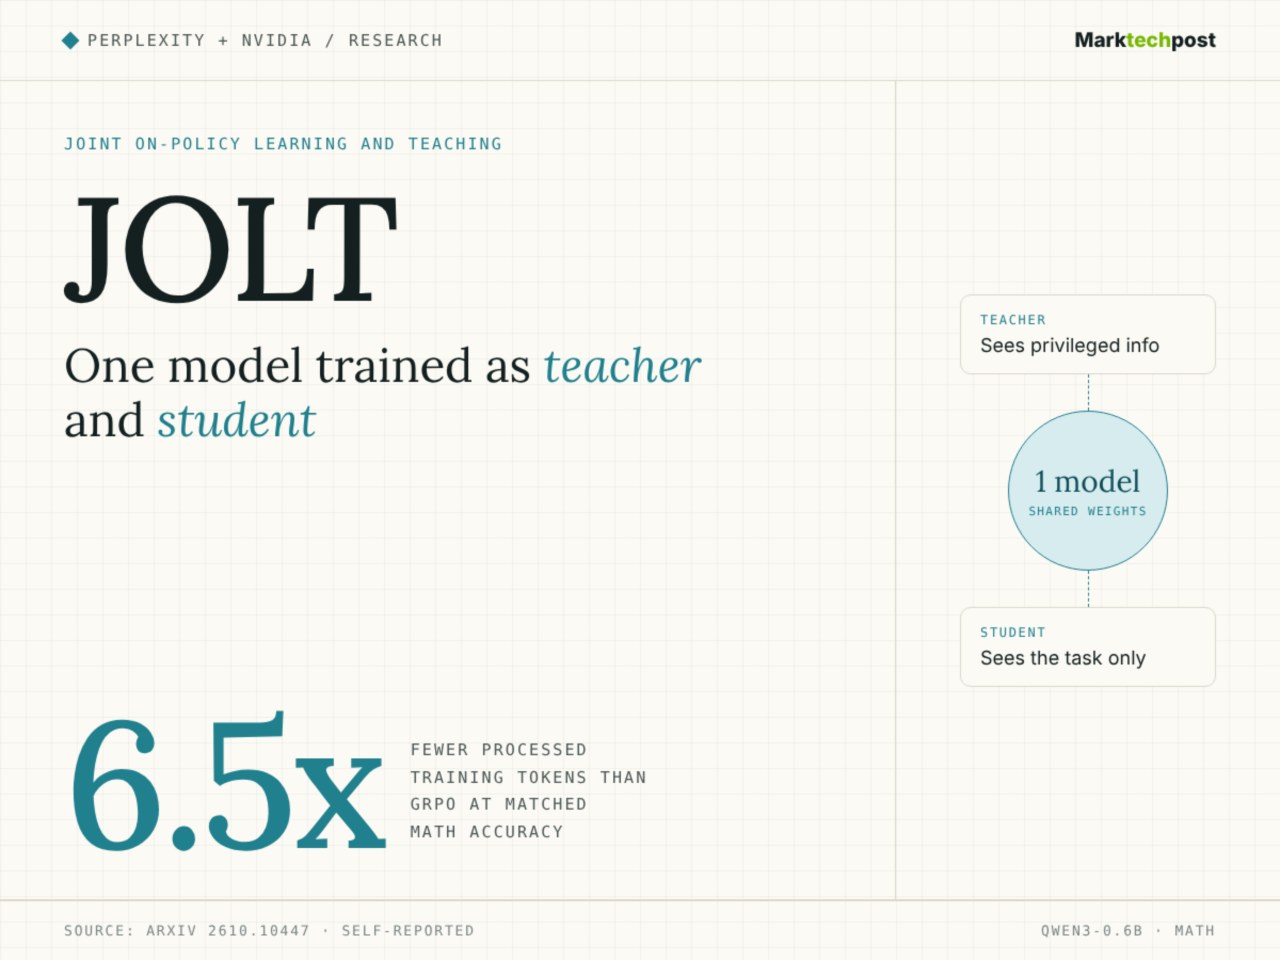
Исследователи из Perplexity и NVIDIA представили метод обучения с подкреплением JOLT. Технология основана на принципе самодистилляции и использует «согласованного с наградой» учителя. Такой подход позволяет модели-учителю выбирать действия с высоким преимуществом, оставаясь при этом в рамках политики студента, что решает проблему разрыва в обучении.
В ходе тестирования на пяти различных базовых моделях JOLT+ показал лучшие результаты по сравнению с методом GRPO. На бенчмарке GSM8K прирост составил 1,5 балла, на MATH — 4,2 балла, на LCBv6 — 3,0 балла, а на AppWorld — 9,9 балла. В Terminal-Bench 2.1 показатели JOLT+ достигли 10,96% pass@1 и 34,83% pass@32 против 8,25% и 30,34% у GRPO.
Метод JOLT значительно повышает эффективность обучения. Для достижения точности 63,44% на бенчмарке MATH модели JOLT потребовалось 1,30 миллиона обработанных токенов, тогда как GRPO затратил 8,40 миллиона. Это обеспечивает сокращение затрат ресурсов в 6,5 раза, а при подсчете только токенов завершения разрыв увеличивается до 13 раз.
JOLT также демонстрирует более высокий предел точности. Модель выходит на плато около 72% на задачах MATH. Для сравнения, показатели GRPO стабилизируются на уровне 70%, а OPSD — около 62%.