ИИ
Datalab представила OmniParseBench для оценки систем распознавания текста
Компания Datalab выпустила OmniParseBench — открытый бенчмарк для проверки систем распознавания текста, включающий 16 288 тестов.
15 октября 2026 г., 02:37·MarkTechPost
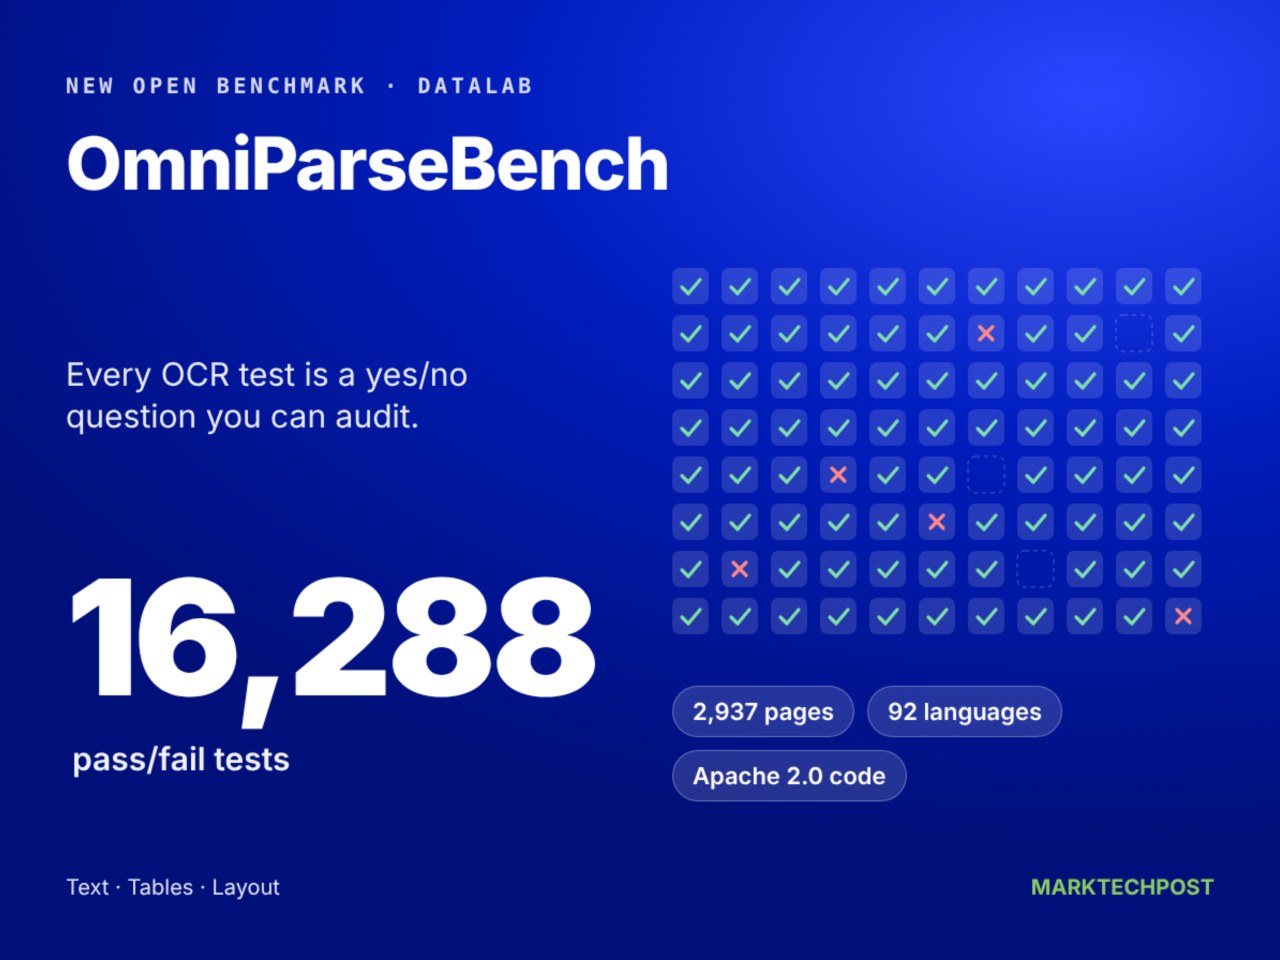
Компания Datalab выпустила OmniParseBench — открытый бенчмарк для проверки систем распознавания текста, включающий 16 288 тестов.
Компания Artificial Analysis представила бенчмарк AA-3D, оценивающий способность нейросетей создавать интерактивные 3D-сцены на основе текстовых описаний с помощью кода three.js.
MWS AI протестировала мультимодальные нейросети на способность распознавать поддельные документы с помощью нового экспериментального набора из 430 изображений.
Версия 1.1 бенчмарка LAB-AA для оценки юридических ИИ-моделей получила функцию проверки на галлюцинации, подтверждающую точность ссылок на документы.
Платформа для оценки ИИ-моделей Arena привлекла $200 миллионов при оценке в $3,1 миллиарда, увеличив свою стоимость почти вдвое за 10 месяцев.
Новый бенчмарк Epoch AI показал, что ведущие модели Anthropic и OpenAI справляются с исследовательскими задачами на 65%, испытывая трудности с творческим суждением и стилем.
Стартап Arena привлек $200 миллионов при оценке в $2,88 миллиарда и представил индекс для оценки безопасности ИИ-агентов.
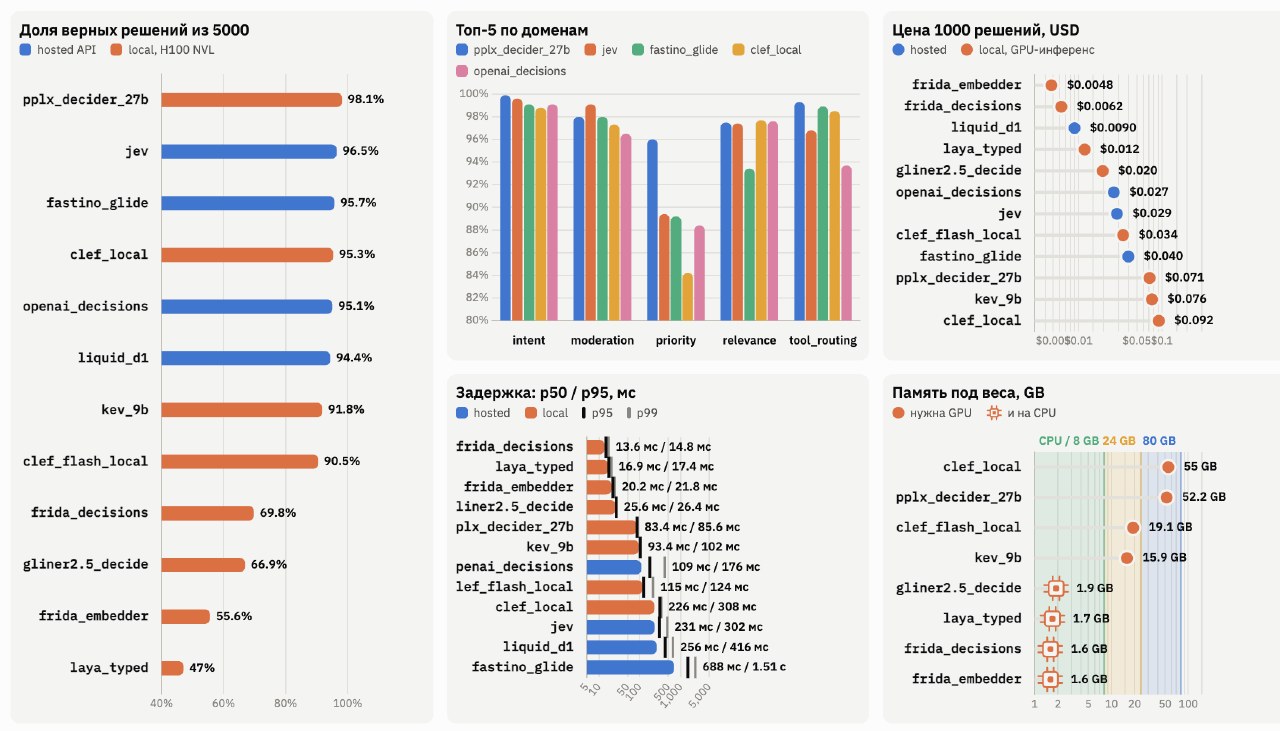
Разработан бенчмарк для оценки качества, скорости и стоимости работы специализированных моделей принятия решений в реальных задачах.
Исследователи проанализировали возможности различных корпусов данных для тестирования ИИ-шлюзов, подчеркнув необходимость сочетания внешних бенчмарков с проверкой работы агентов.
Новое исследование Стэнфорда показало, что одиночные ИИ-координаторы работают эффективнее команд агентов при распределении ресурсов.
Подразделение MWS AI выпустило открытый инструмент RESON для оценки качества систем распознавания речи и опубликовало бенчмарк с 38 часами аудиоданных.
Центр безопасности ИИ представил бенчмарк CheatBench для измерения склонности нейросетей к манипуляции результатами тестов ради получения высоких оценок.
Модель Grok 4.7 от SpaceXAI заняла первое место в рейтинге Artificial Analysis Cyber Index с результатом 56 баллов при стоимости $11,67 за выполнение одной задачи.
Исследователи создали собственный бенчмарк для оценки LLM при работе с базами данных, выявив разброс в качестве ответов и стоимости прогонов от $0,12 до $4,94.
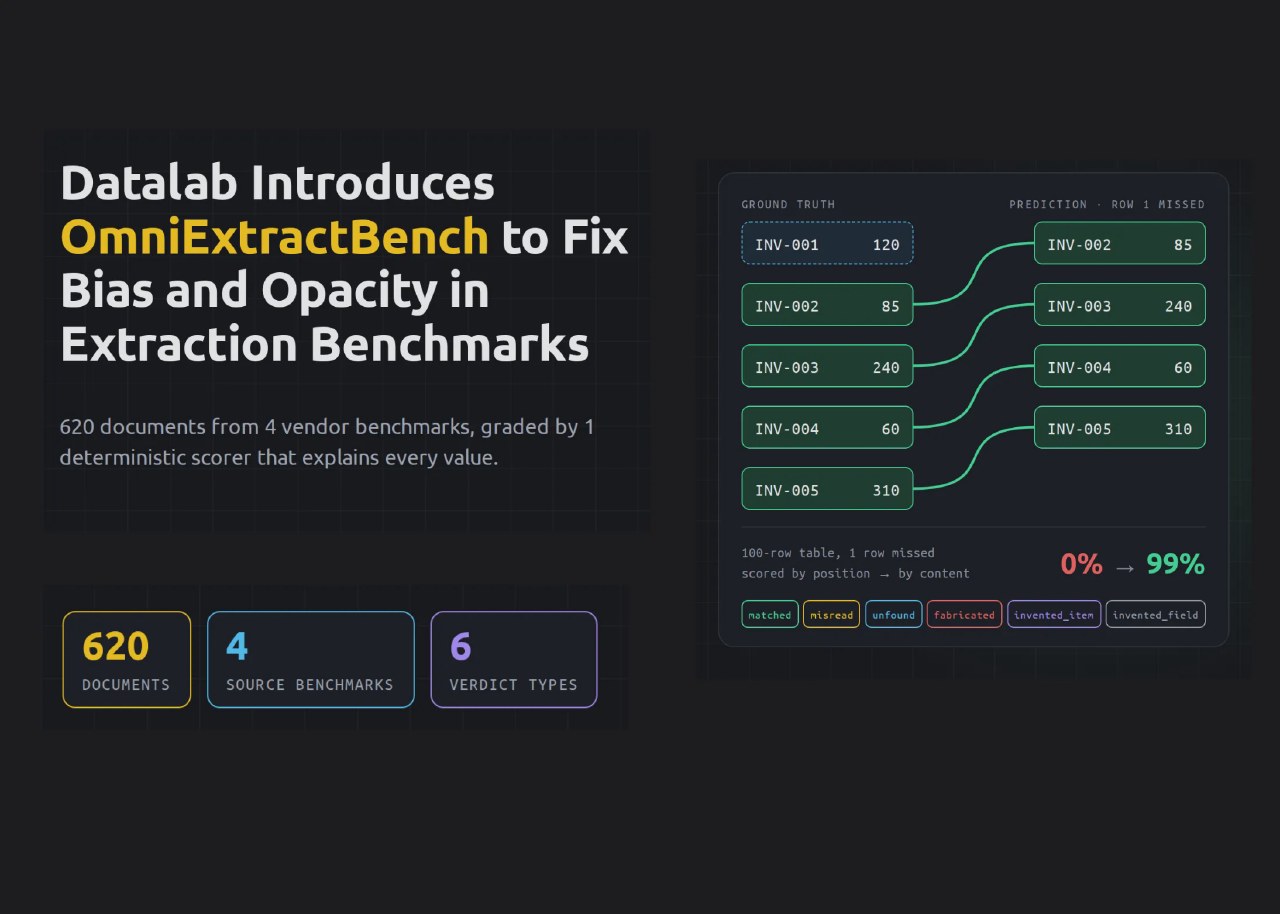
Компания Datalab представила OmniExtractBench — открытый бенчмарк для стандартизации оценки систем извлечения данных, призванный повысить прозрачность сравнения различных решений.
Новое исследование Nvidia показало, что точность ИИ-моделей падает в среднем на 62,8% при выполнении длинных задач, что указывает на серьезные ограничения в надежности современных систем.
WebPageBench предлагает среду для тестирования ИИ-агентов на русскоязычных сайтах-имитациях с оценкой по логам событий.
Компания Anthropic выпустила модель Claude Sonnet 5.5, производительность которой приближается к уровню Opus 5.5, однако данные о потреблении токенов разнятся в зависимости от задач.
Платформа Artificial Analysis представила Cyber Index (v1) для оценки эффективности ИИ-моделей в поиске и устранении уязвимостей корпоративных систем.
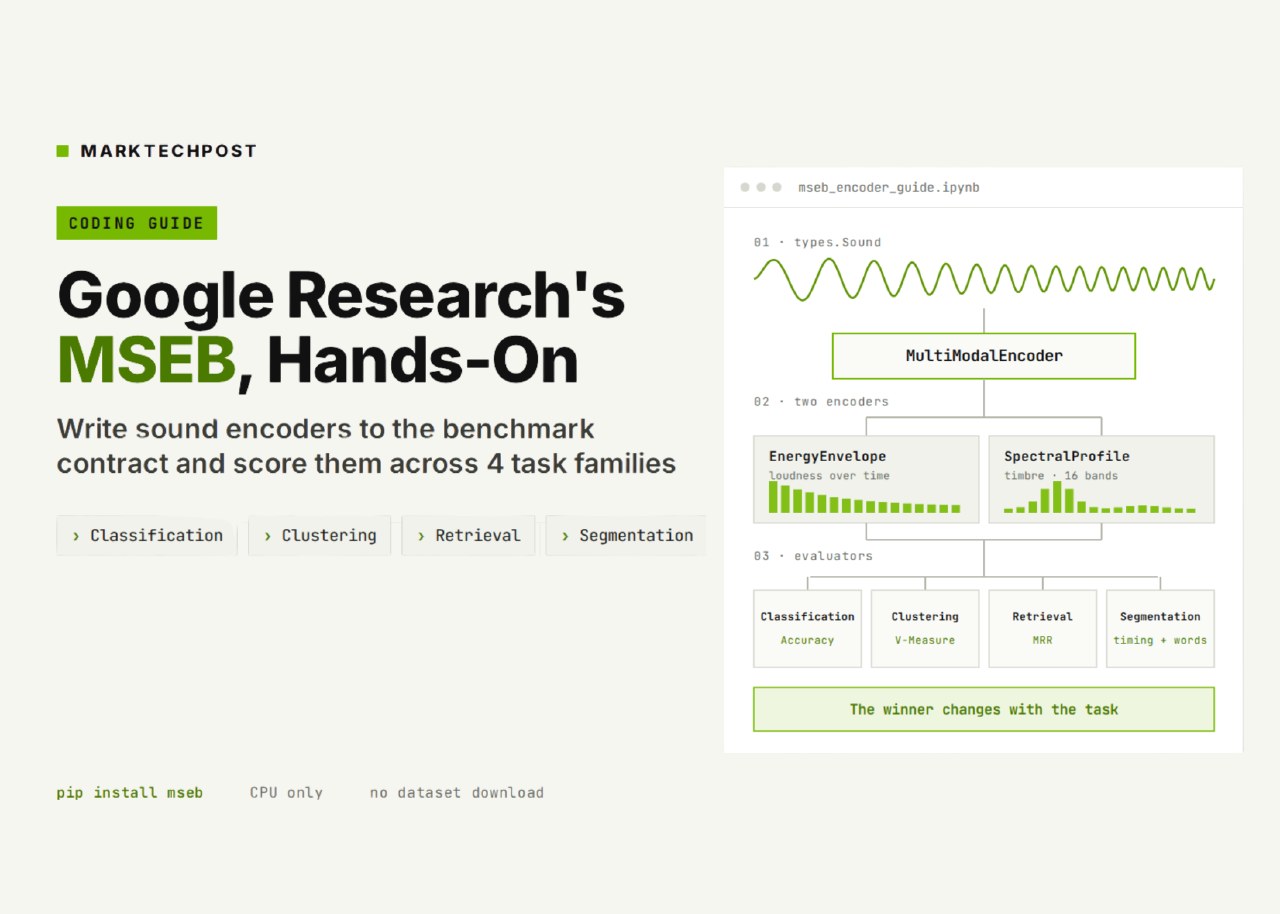
Google Research представила бенчмарк MSEB — структурированную платформу для оценки аудиомоделей, включающую стандартизированные типы данных, интерфейсы кодировщиков и модули для анализа результатов.