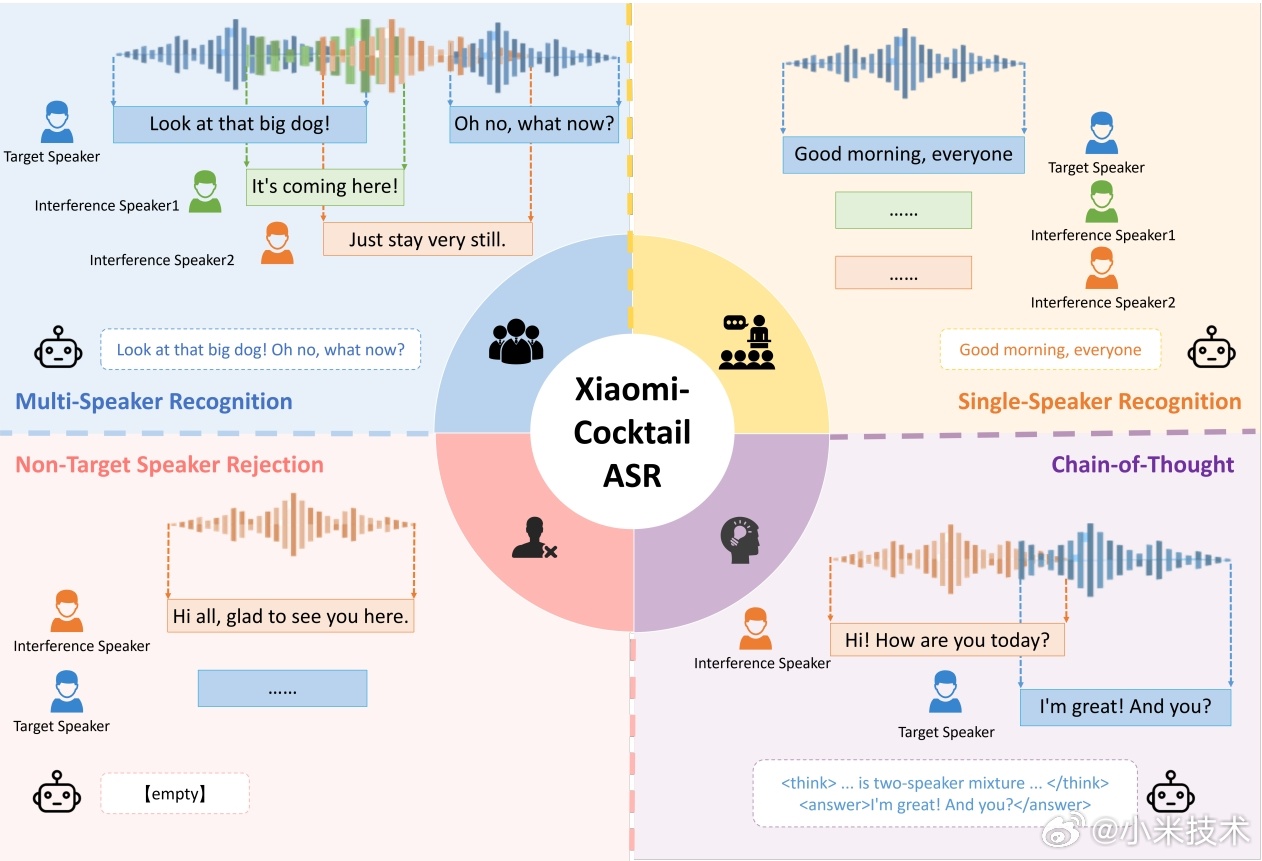
Компания Xiaomi представила и открыла исходный код промышленной модели распознавания речи Xiaomi-CocktailASR-1. Разработка призвана решить проблему «коктейльной вечеринки», при которой точность распознавания голоса резко падает, если в помещении одновременно говорят несколько человек.
Модель построена на архитектуре end-to-end LLM. В качестве подсказки система использует фрагмент аудиозаписи целевого спикера, что позволяет выделять и транскрибировать только его речь в условиях шума. По данным разработчиков, решение показывает лучшие результаты на ключевых тестовых наборах данных.
В сценариях с одним говорящим Xiaomi-CocktailASR-1 сопоставима со стандартными моделями ASR. Система умеет игнорировать посторонние голоса и выводить пустой текст, если целевой пользователь отсутствует. Также поддерживается режим цепочки рассуждений, который позволяет интерпретировать полученные результаты распознавания.