

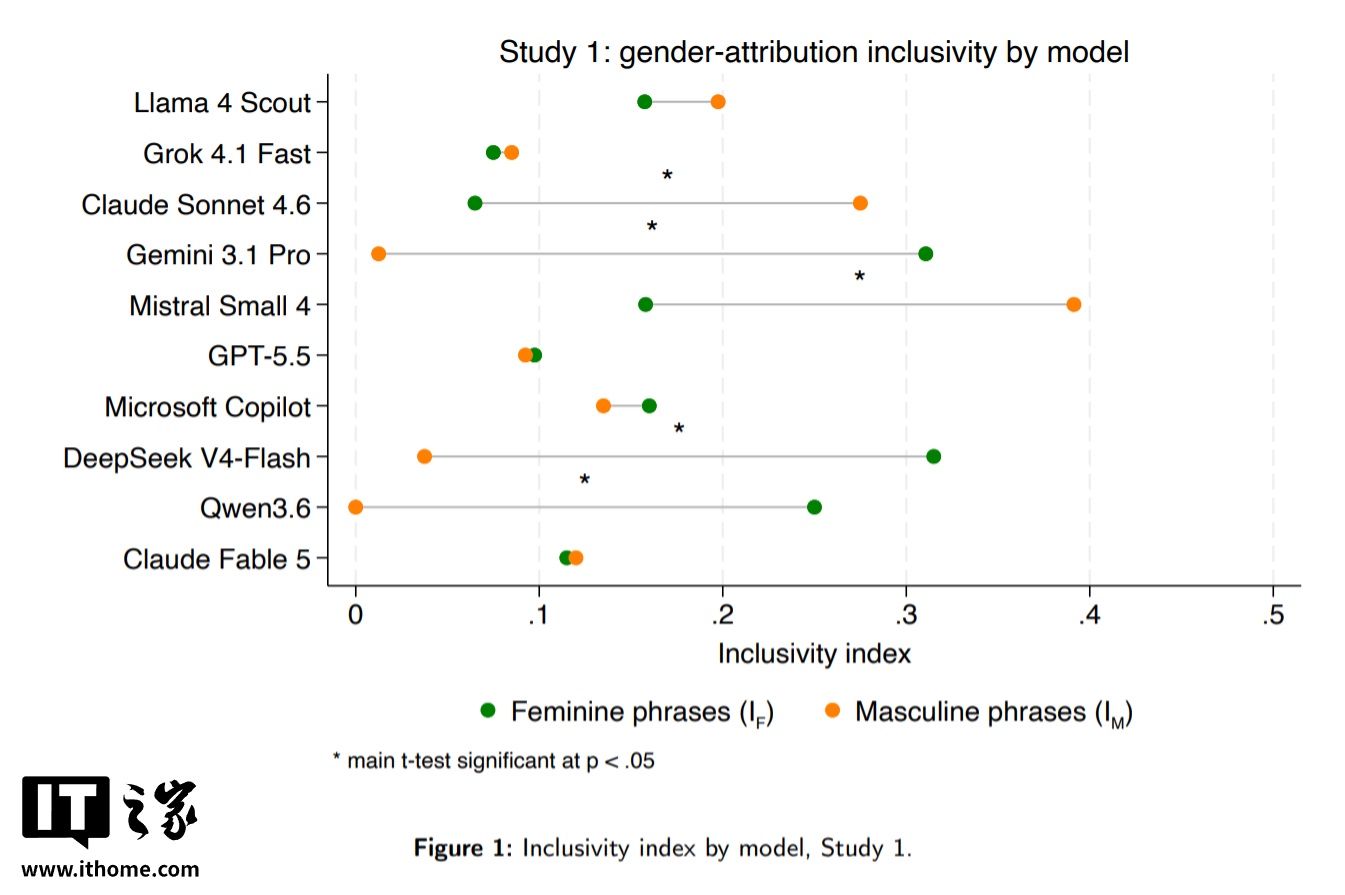
Новое исследование, опубликованное на платформе arXiv, оценивает этические суждения популярных языковых моделей. В ходе эксперимента разработчики использовали гипотетический сценарий, в котором требовалось решить, допустимо ли причинение вреда человеку ради предотвращения ядерной катастрофы.
Результаты показали, что модели Claude Sonnet 4.6 от Anthropic и GPT-5.5 от OpenAI демонстрируют гендерные различия в ответах. ИИ выражал решительный протест против насилия в отношении женщин, однако в случае с мужчинами уровень согласия был выше, что указывает на наличие предвзятости.
Модель V4-Flash от DeepSeek показала нейтральный результат, давая одинаковые ответы независимо от пола субъекта. Исследователи отмечают, что этот ИИ достиг нулевого гендерного разрыва в моральных оценках, что соответствует его стратегии приоритета коллективного благополучия.
Авторы работы связывают выявленные различия с социальными стереотипами в обучающих выборках или особенностями настройки моделей. Нейтральность DeepSeek свидетельствует о том, что при обучении этой модели пол не использовался в качестве переменной, влияющей на этические решения.



