

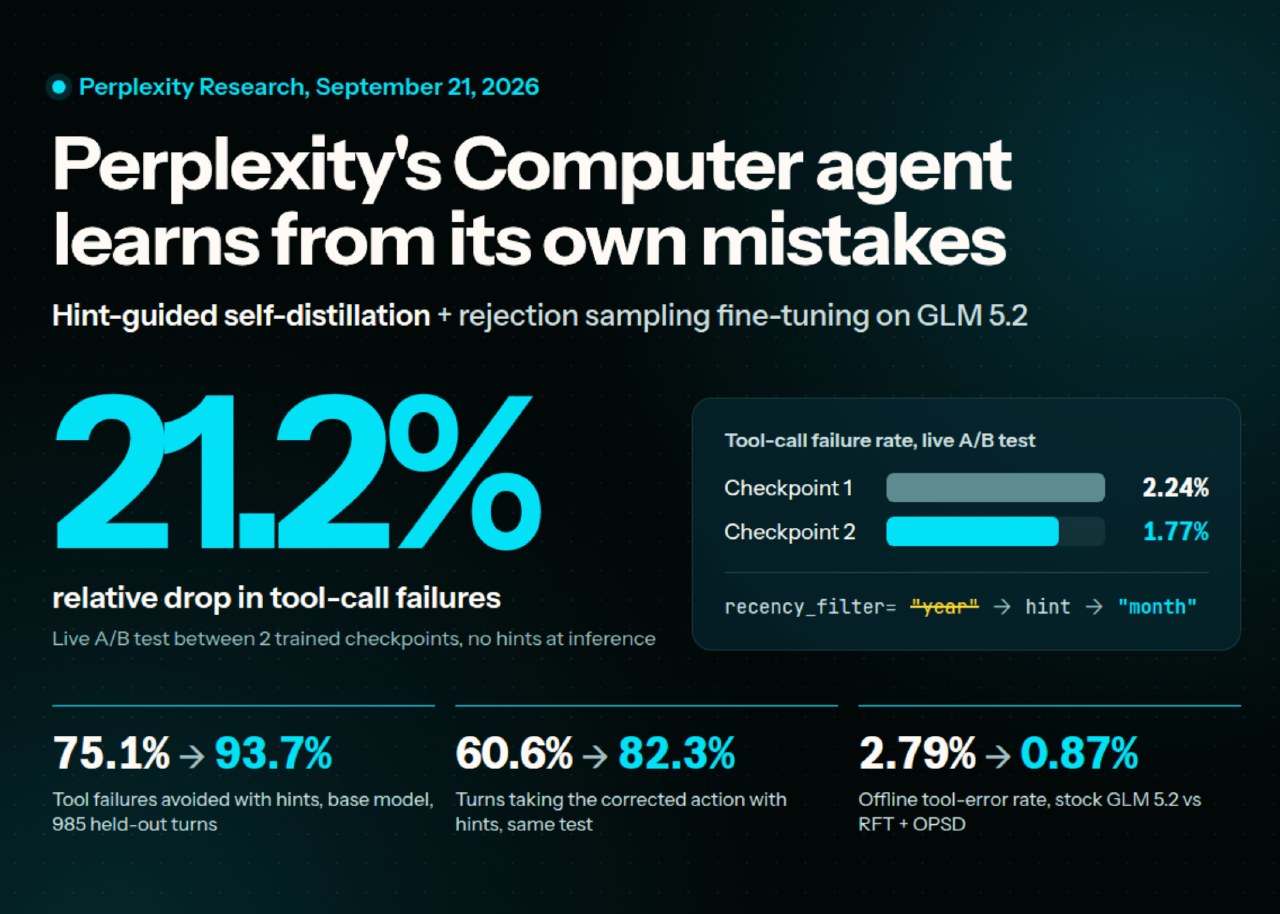
Компания Perplexity представила метод обучения компьютерного агента с использованием подсказок и самодистилляции. Разработчики не планируют публиковать веса модели или код обучения, ограничивая доступ к инструменту рамками сервиса Perplexity Computer. При этом базовая модель GLM 5.2 доступна для использования на платформе Hugging Face.
Новый подход позволяет исправлять ошибки, допущенные агентом, вместо простого копирования успешных сессий. Команда разделяет процесс на имитацию правильного поведения и корректировку конкретных неверных действий. Система использует как успешные, так и неудачные сессии для обучения, извлекая из них данные об ошибках и способах их устранения.
Механизм On-Policy Self-Distillation предполагает двойной прогон модели GLM 5.2. В первом случае модель-учитель получает подсказку с инструкцией по исправлению, а во втором модель-ученик работает без неё. Вероятности токенов учителя выступают в роли целевых значений, а общая функция потерь объединяет кросс-энтропию и дивергенцию Кульбака-Лейблера.
Для обучения используются сессии Perplexity Computer, из которых исключены данные пользователей, отказавшихся от участия, и информация личного характера. Качество сессий оценивается LLM-судьями: для включения в выборку задача должна получить оценку 4 или 5 по пятибалльной шкале, а результат — одобрение двух независимых судей. Анализ жалоб пользователей также проходит через проверку тремя LLM-судьями.



