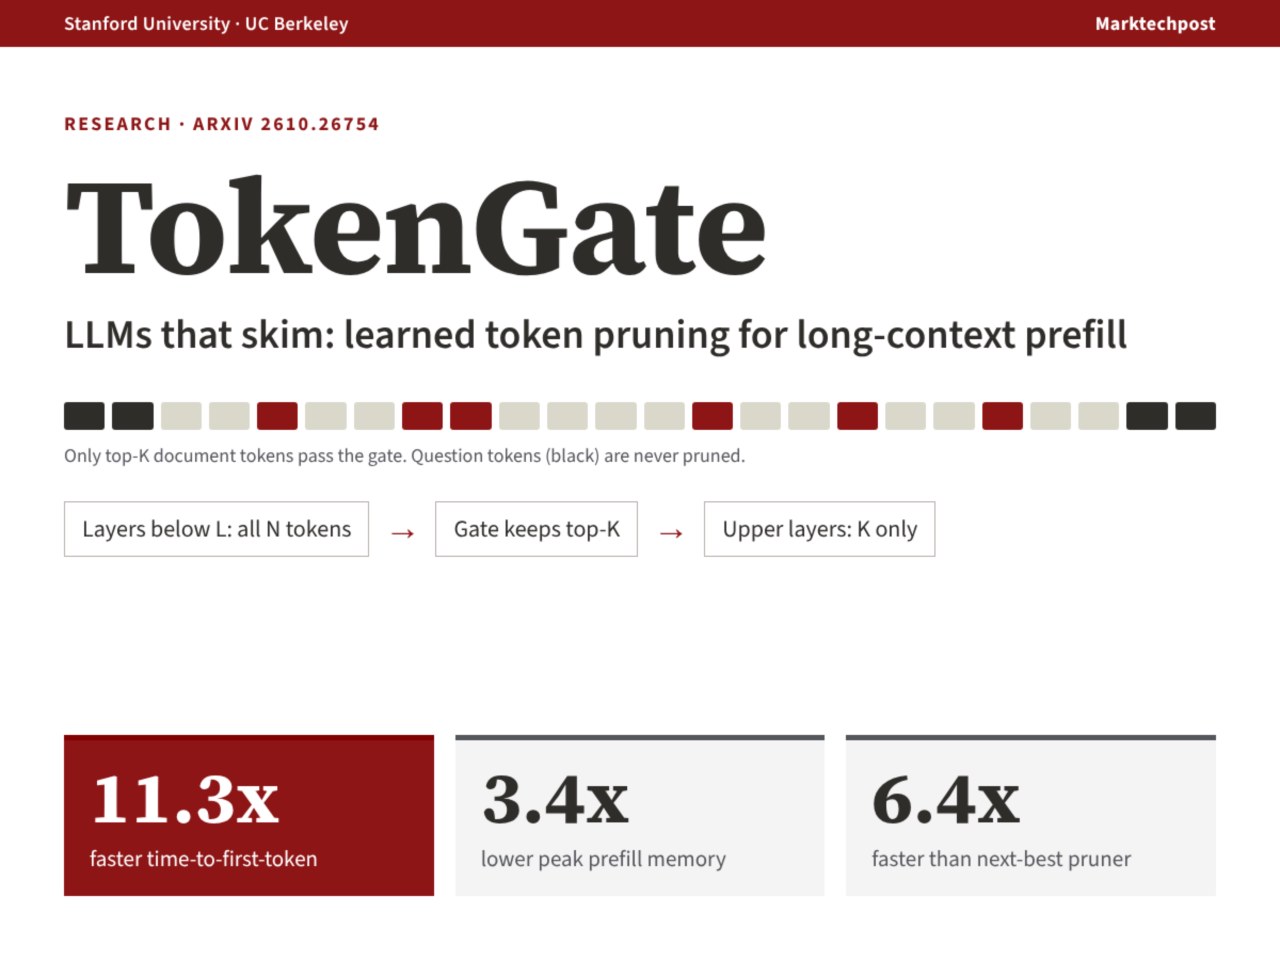
ИИ-модели обрабатывают текст с помощью токенов — фрагментов слов или знаков препинания. При работе с русским языком расход токенов в 2–4 раза выше, так как словари моделей преимущественно ориентированы на английский язык.
Контекстное окно определяет объем данных, которые модель удерживает в памяти. Старые версии поддерживали 4 000 токенов, современные — более миллиона. При заполнении окна модель удаляет наиболее старые данные.
Галлюцинации возникают из-за того, что модели предсказывают вероятные токены, а не обращаются к базе данных. ИИ выдает вымышленные ответы с высокой уверенностью, поэтому он не подходит для работы с критически важными фактами.
Параметр температуры регулирует предсказуемость ответов. Низкие значения (ближе к 0) обеспечивают точность для программирования и анализа данных. Высокие значения (ближе к 1) делают ответы креативными и менее предсказуемыми.
Технология RAG позволяет моделям работать с внешними данными без дообучения. Система находит релевантные фрагменты в векторной базе данных и передает их модели как контекст. Это основа большинства современных ИИ-сервисов для работы с документами.