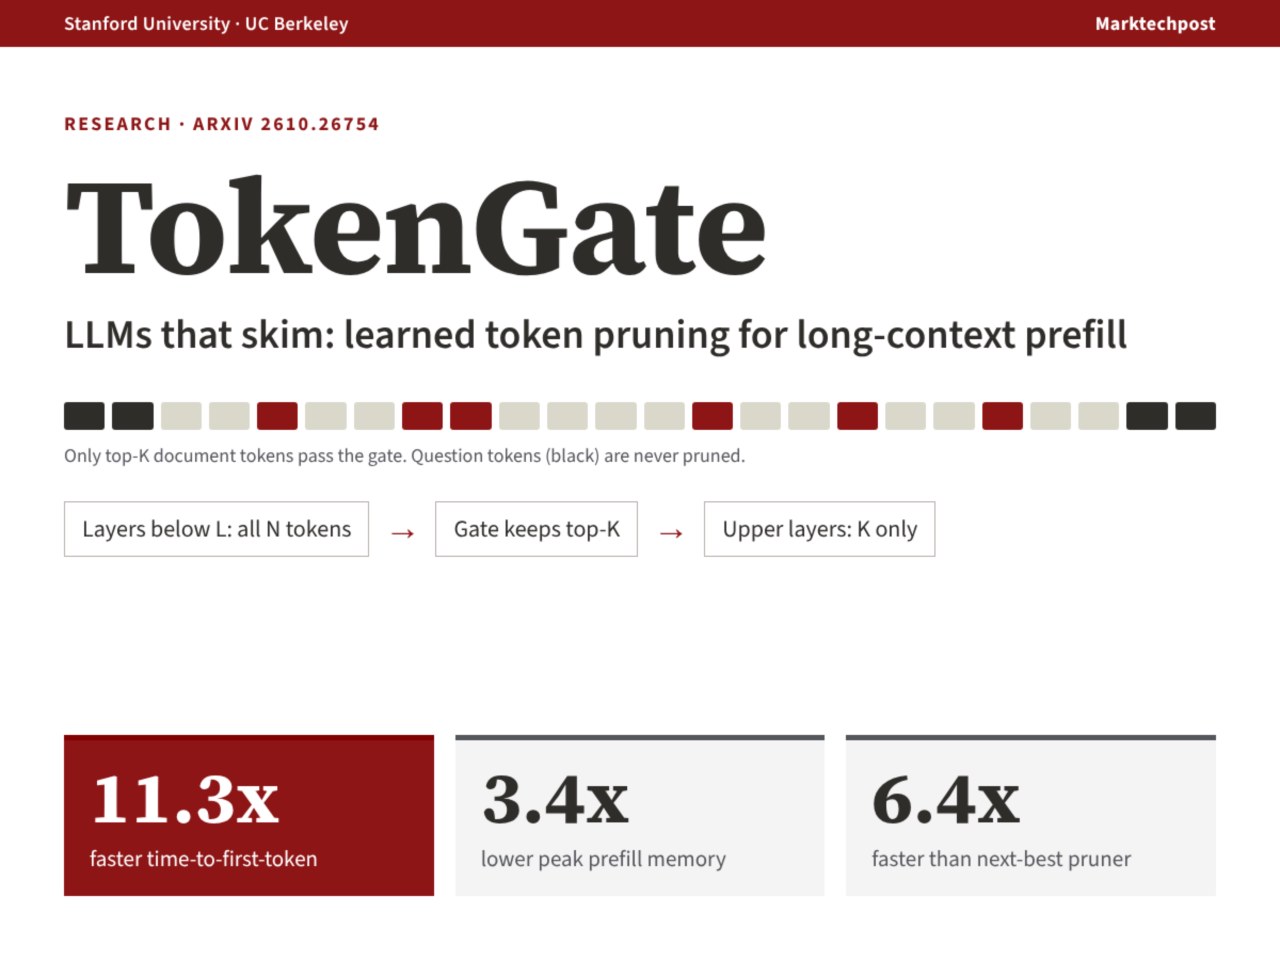
Исследователи из Стэнфорда и Калифорнийского университета в Беркли представили TokenGate — компонент для предобученных LLM, реализующий обучаемую обрезку токенов. Метод решает проблему квадратичного роста затрат на внимание, используя обучаемый селектор. Он позволяет градиентам проходить обратно в процессе обучения, обходя недифференцируемость классического выбора Top-K.
Разработчики протестировали решение на модели Qwen3-1.7B в пяти бенчмарках, включая RepoBench-P и needle-in-a-haystack. TokenGate показал ускорение префилла до 11,3 раза. В тестах на NIAH 32k при использовании гейтинга на третьем слое точность соответствовала полному префиллу, при этом скорость работы оказалась в 3,8 раза выше, чем у полного префилла, и в 2,1 раза выше, чем у FastKV.
Обучение TokenGate основано на рецепте TRL/PEFT, где каждый шаг выполняется в 1,3 раза медленнее, чем при стандартном LoRA. Исследователи отметили, что обучение сходилось быстрее в четырех из пяти задач: среднее время составило 1,8 часа на A100 против 2,2 часа у базовых решений. Для работы требуется Python 3.10+ и CUDA PyTorch 2.9+.
Система использует обучаемый коэффициент усиления для каждой головы и температуру для уточнения выбора токенов. Поддержка различных бюджетов обеспечивается усреднением потерь полного контекста и случайного бюджета. Чекпоинты доступны на Hugging Face, а опциональное ядро FlashAttention-2 с key-bias ускоряет инференс для плотных моделей Qwen3.