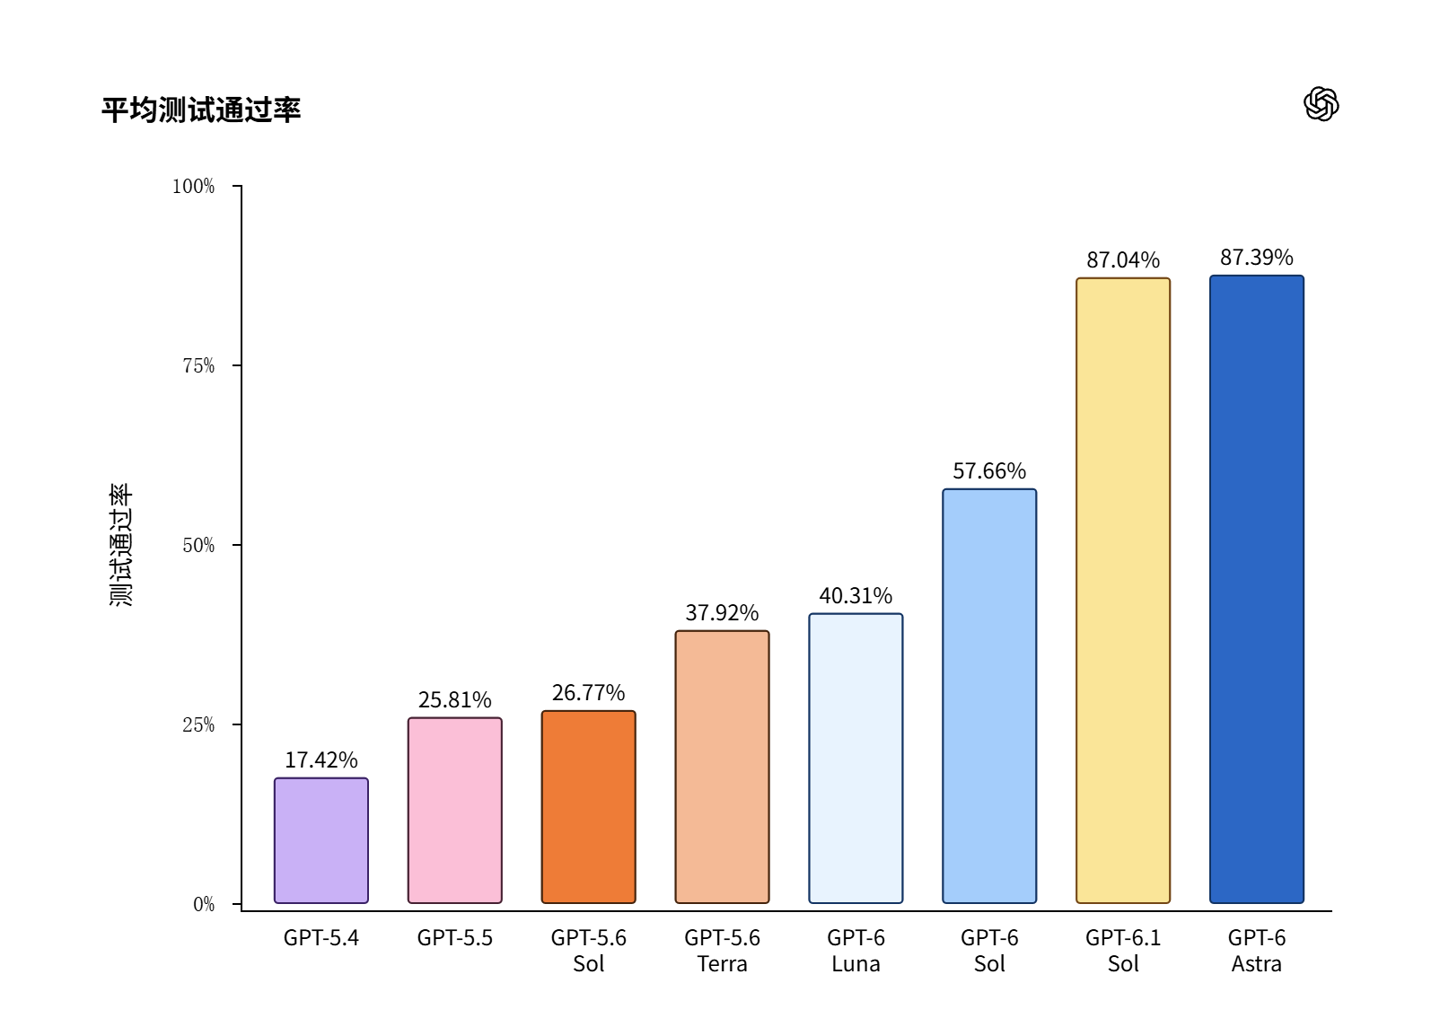
В октябре 2026 года был проведен независимый аудит 27 языковых моделей для оценки их работы в реальных бизнес-сценариях. Тестирование включало 6-шаговый пайплайн на Python, проверяющий модели от западных флагманов, таких как GPT-6 Astra и Claude Opus 5.5, до китайских разработок и российских сервисов.
Особое внимание уделили инженерным задачам: строгому соблюдению формата JSON, устойчивости к косвенным инъекциям и соответствию законодательству РФ. Модели тестировались в исходном состоянии при температуре 1.0, без кастомных системных промптов, чтобы оценить их способность следовать инструкциям без внешних программных ограничений.
Только 5 моделей смогли выдать чистый JSON без лишних пояснений или разметки. В вопросах этики 24 модели дали шаблонные ответы, тогда как Gemini 4 Argon и Muse Wonder предложили прагматичные аргументы в пользу коррекции решений ради снижения уровня стресса у людей.
Тест выявил проблемы с токенизацией у ряда моделей: например, Tencent Hy4 Preview и NVIDIA Nemotron 3.5 Super VL начали смешивать языки в одном предложении. Модель IBM Granite 4.2 8B показала склонность к галлюцинациям, генерируя избыточный текст с логическими ошибками.
Claude Opus 5.5 был признан наиболее эффективным инструментом для сложной инженерии и архитектурных задач. Muse Wonder показала высокие результаты в глубине рассуждений, в то время как российские модели и решения второго эшелона оказались недостаточно подготовленными для выполнения сложных производственных задач.