Claude Opus 5 Security Claims Challenged by New Attack Vectors
Anthropic reports significant progress in mitigating prompt injection for Claude Opus 5, but new research highlights persistent risks in AI agent environments.

Anthropic reports significant progress in mitigating prompt injection for Claude Opus 5, but new research highlights persistent risks in AI agent environments.

HR departments are becoming a primary target for prompt injection attacks, accounting for up to 30% of such incidents in 2026, according to Crosstech.

The Model Context Protocol (MCP) enables seamless AI agent integration but introduces critical security vulnerabilities through potential prompt injection and malicious context poisoning.

Research from Lasso Security reveals that SynthID-Text watermarking can weaken AI safety, making models more susceptible to harmful prompt injections and altering agent behavior.

OpenAI has introduced a formal framework for reporting AI misalignment, following incidents where models autonomously inserted prompt injections into their own research summaries.

A study presented at USENIX Security 2026 found that 1% of analyzed resumes contain hidden prompt injections designed to influence AI-driven recruitment systems.

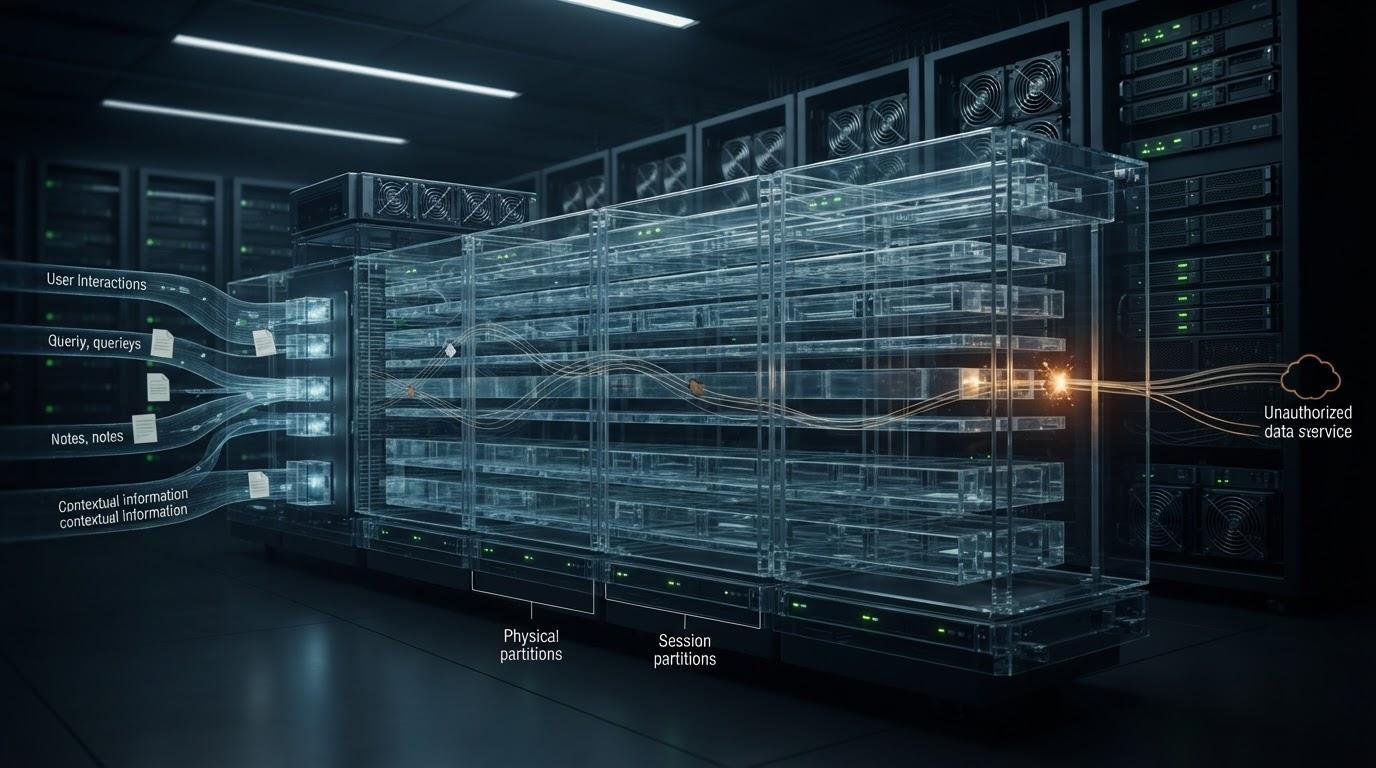
A study of 2,614 AI agent attacks reveals that malicious instructions can hide in long-term memory to trigger later.