ИИ
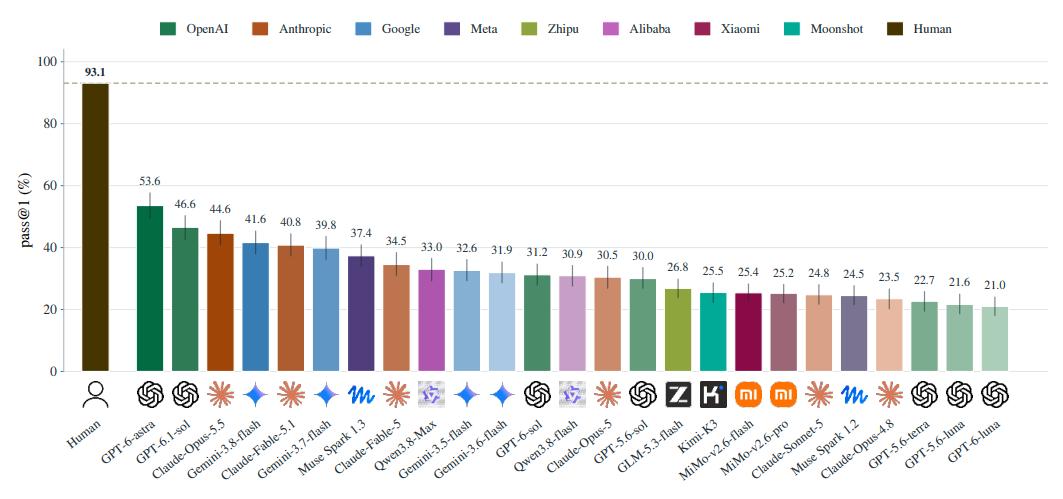
Бенчмарк Humanity's Sixth Sense выявил проблемы ИИ с пониманием визуального контекста
Новый бенчмарк Humanity's Sixth Sense показал, что современные ИИ-модели не способны считывать визуальный контекст на уровне человека, проваливая тесты на интуитивное понимание сцен.
11 октября 2026 г., 17:41·iXBT.com