

Компания StepStar представила серию моделей StepAudio 3, в которую вошли пять решений: StepAudio 3 Realtime, StepAudio 3 ASR, StepAudio 3 TTS, StepAudio 3 Gen и StepAudio 3 Music. Все новинки уже доступны на открытой платформе разработчика.
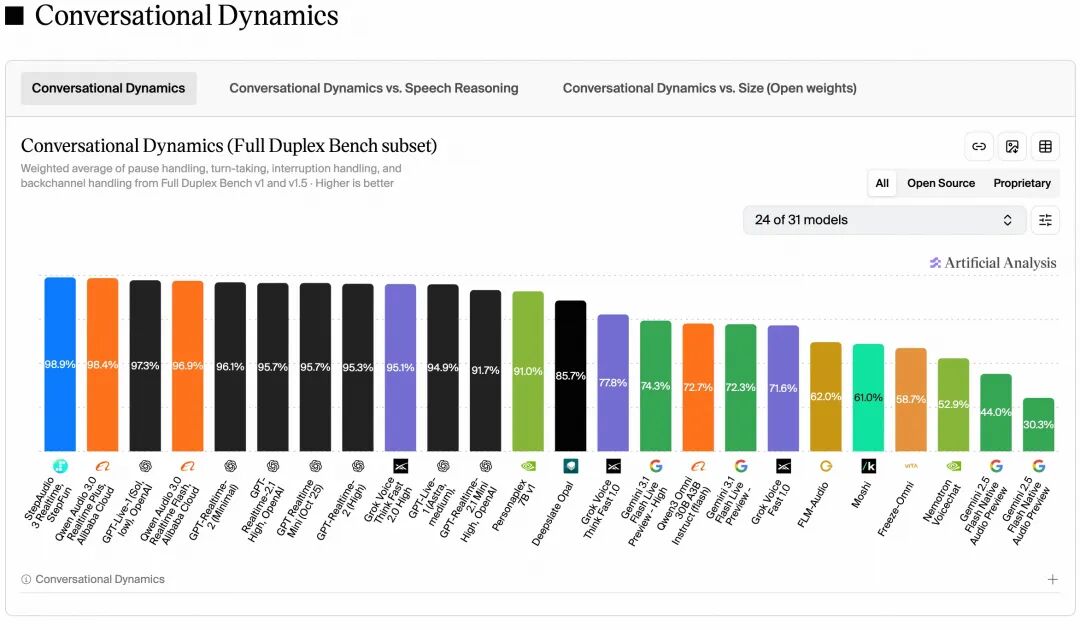
Модель StepAudio 3 Realtime заняла первое место в рейтинге Artificial Analysis Conversational Dynamics с результатом 98,9% и лидирует в категории Speech Reasoning с точностью 99,7%. Система поддерживает полнодуплексный режим общения и способна параллельно выполнять рассуждения и генерацию речи.
Модель StepAudio 3 ASR показала уровень ошибки WER 1,7% в рейтинге Artificial Analysis, что позволило ей разделить первое место в мире. Инструмент распознает диалекты, смешанную речь и профессиональную терминологию, адаптируясь к контексту в медицине, юриспруденции и финансах.
StepAudio 3 TTS ориентирована на создание естественной речи с учетом интонаций, пауз и эмоциональной окраски. Модель использует потоковую архитектуру, что позволяет синтезировать голос в реальном времени, имитируя человеческие особенности общения, включая смех или заминки.
Модель StepAudio 3 Gen позволяет создавать аудиоконтент, объединяющий голоса, звуковые эффекты и музыку на основе текстовых описаний. Пользователи могут управлять характеристиками персонажей и таймингом, что упрощает производство аудиовизуального контента для игр и видео.
StepAudio 3 Music поддерживает как создание композиций с нуля, так и интерактивное редактирование. Модель работает с различными входными данными, включая нотацию ABC и вокальные партии, позволяя дорабатывать структуру песен, добавлять аранжировки и управлять музыкальными инструментами.



