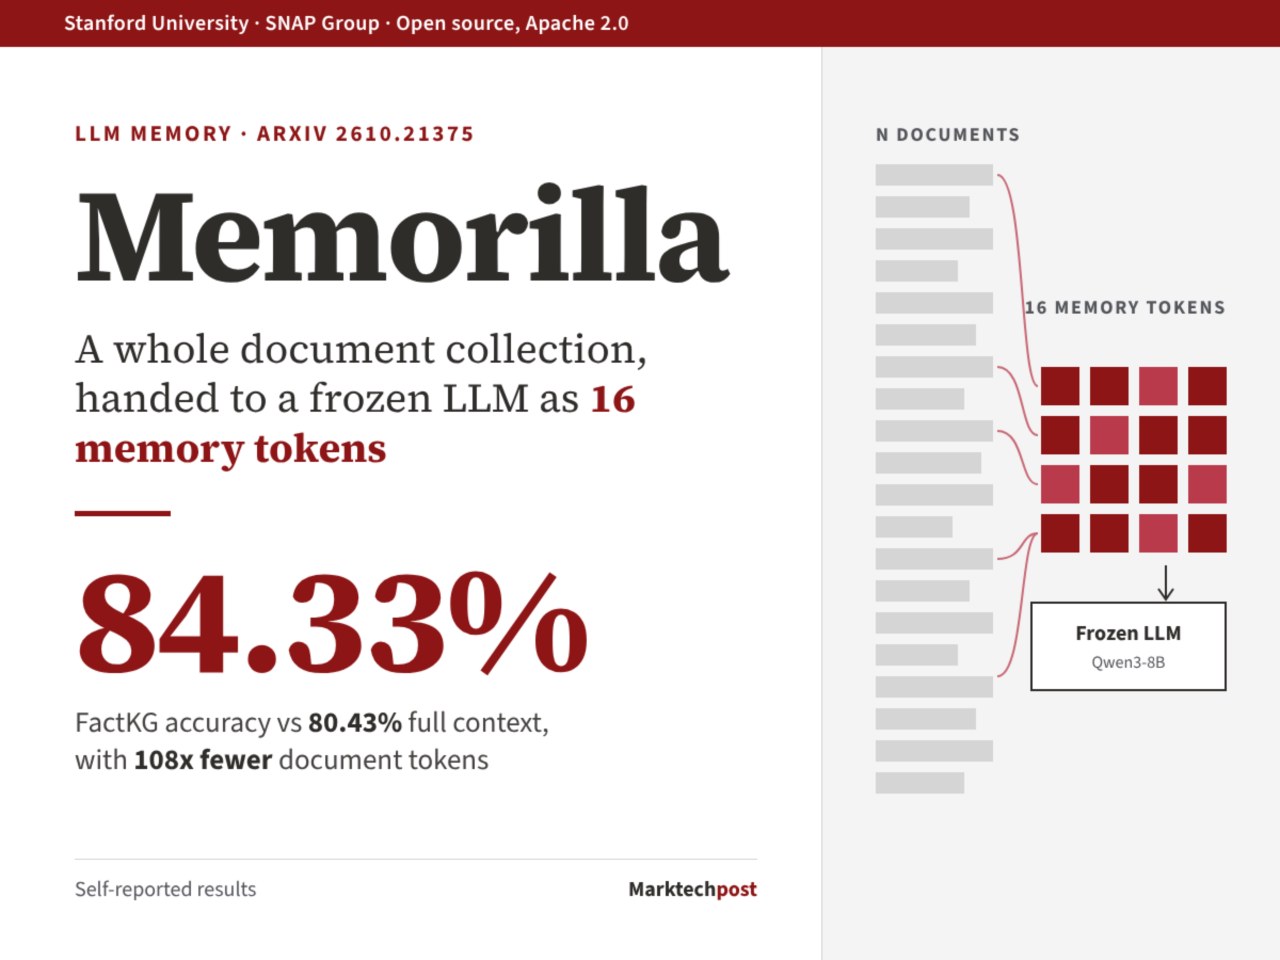
Исследователи из группы SNAP Стэнфордского университета совместно с коллегами из Торонто, Пенсильвании и MIT представили Memorilla. Этот модуль памяти преобразует коллекции документов в 16 векторов для замороженных больших языковых моделей, предлагая альтернативу стандартному контекстному окну и методам поиска.
Процесс обучения включает 194 123 776 параметров для 8B-декодера и проходит в три этапа. На первом этапе используется 1,98 миллиона примеров из Wikipedia, на втором — 1,34 миллиона примеров из наборов данных QA и суммаризации, а на третьем проводится дообучение на восьми бенчмарках. Весь цикл занимает 19 часов на четырех GPU H100.
Тестирование на базе Qwen3-8B показало разные результаты. На NarrativeQA система достигла сжатия в 4 212 раз, заменив 67 385 токенов документов на 16 векторов. В задачах агентной памяти использование восьми токенов повысило показатель успешности агента Qwen3-4B с 18,6% до 24,2%.
Скорость обработки 512 документов на одном GPU H100 составляет 0,74 секунды против 19,9 секунды при полном контексте. При использовании кэша памяти на GPU B200 время отклика составляет 8,1 миллисекунды для 1 миллиона документов и 33 миллисекунды для 4 миллионов, с возможностью ускорения до 5,0 миллисекунд через torch.compile.
Команда опубликовала чекпоинты для Qwen3-8B и набор данных PersonalizationV4, содержащий 149 синтетических пользователей по 200 диалогов на каждого. Развертывание доступно через MemoryVLLM, при этом первый запуск требует загрузки около 25 ГБ данных моделей.