Компания Revolut сократила расходы на ИИ-кодинг на 90% за год. Вместо сторонних сервисов Anthropic Claude Code и OpenAI Codex компания перешла на собственные модели GLM, развернутые на собственной инфраструктуре. Как сообщил руководитель направления эксплуатации и инфраструктуры Дэвид Абитболь, это решение позволило значительно снизить затраты при сохранении эффективности разработки.
ИИ-инструменты внедрены для 2000 инженеров, что ускорило написание кода на 60%, а выполнение задач — на 70%. Ранее компания использовала Gemini и Claude Code, но столкнулась с ограничениями по токенам. Стоимость развертывания GLM-5.1 составила около $0,30 за миллион токенов, что в десять раз дешевле коммерческих аналогов. Сейчас компания использует версию GLM-5.3.
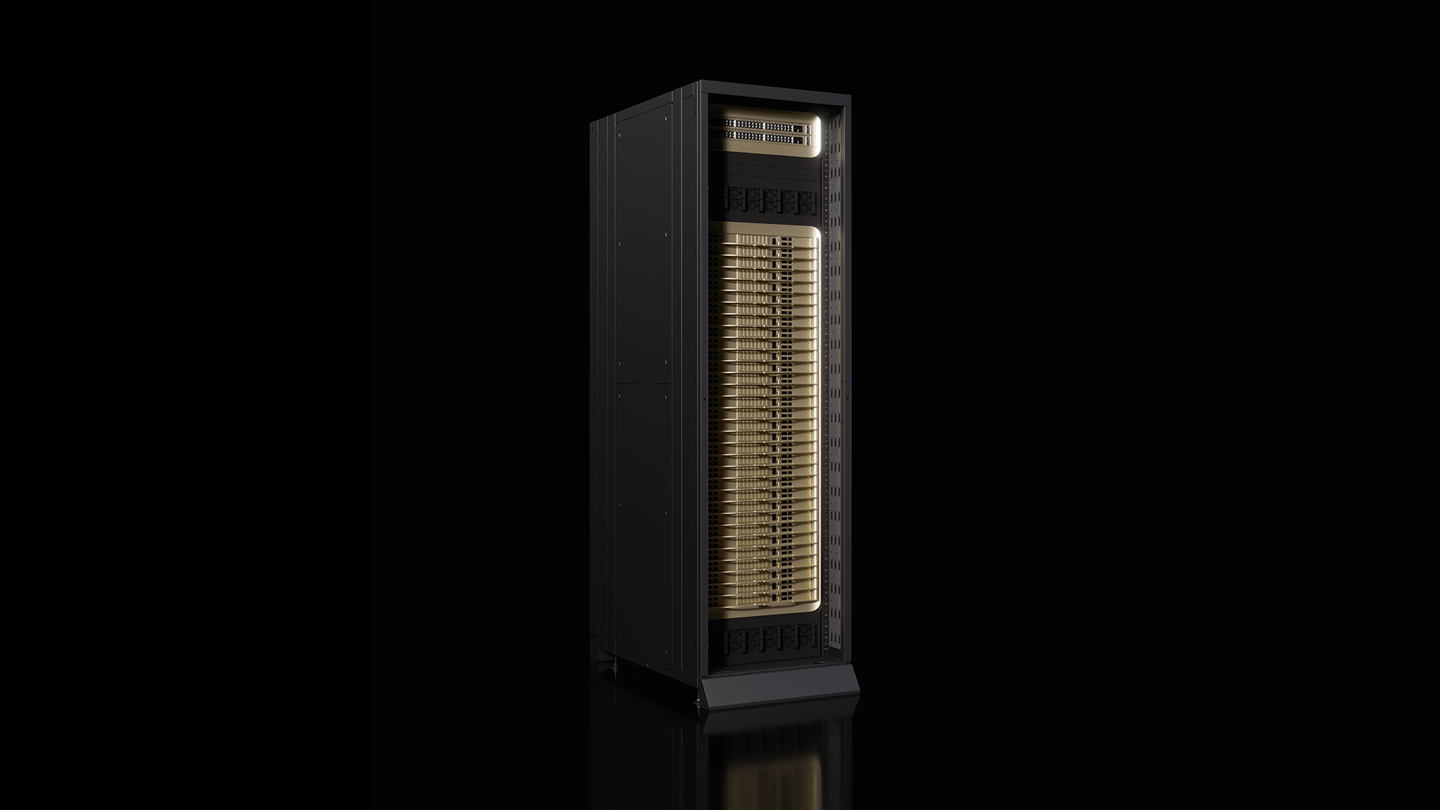
Для работы GLM-5.3 задействовано 56 ускорителей Nvidia B200. Производительность повысили за счет квантования NVFP4, настройки параметров и разделения обработки контекста и генерации. Рабочий контекст ограничен 256 000 токенов. Система выдает первый токен менее чем за три секунды, скорость генерации составляет около 200 токенов в секунду.
GLM-5.3 не заменяет все модели: для анализа изображений интерфейсов маршрутизатор направляет запросы к Gemini или GPT. Абитболь отметил, что вопросы безопасности при использовании китайских моделей решаются за счет локального развертывания или использования региональных облачных ресурсов, что минимизирует риски, связанные с работой через внешние API.