

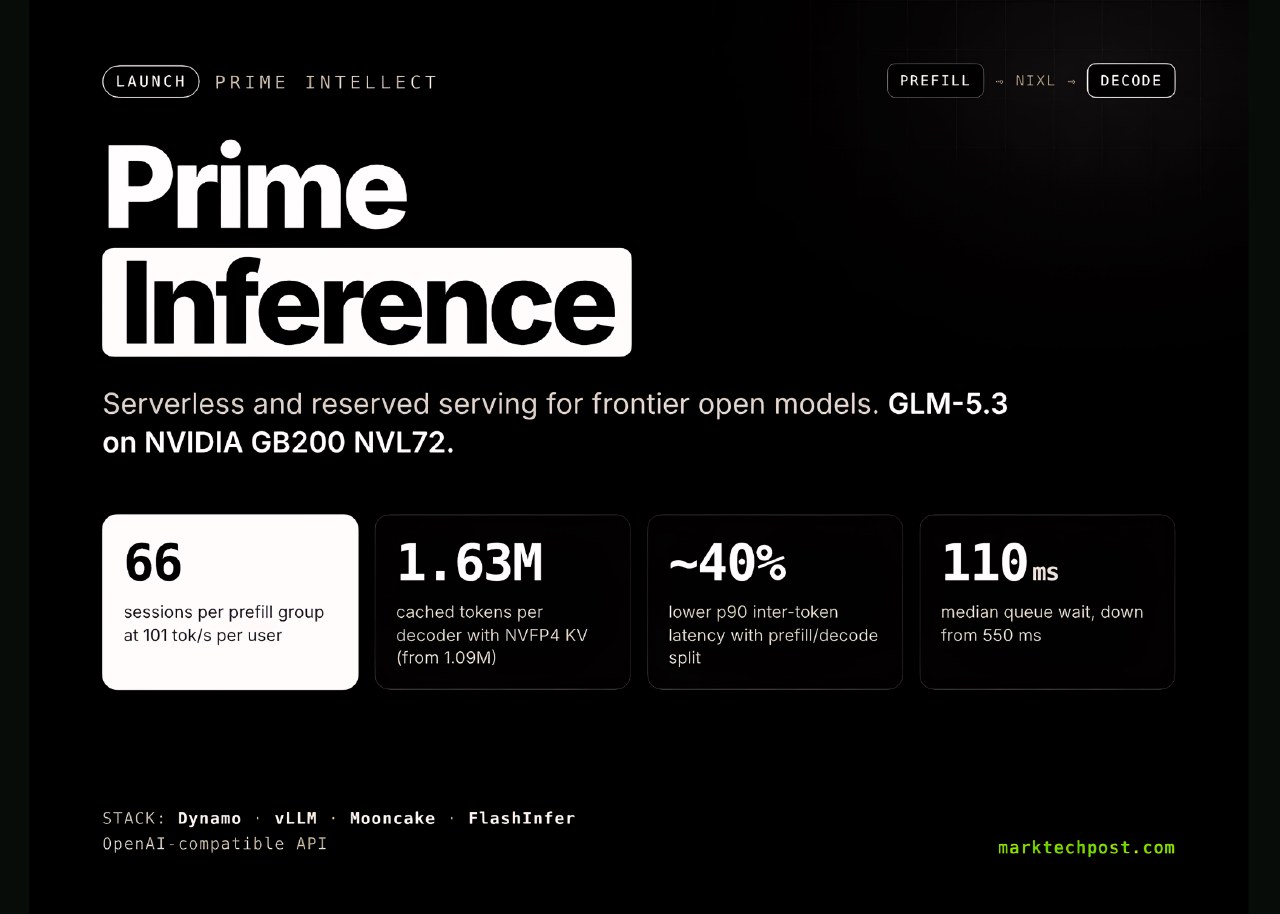
Компания Prime Intellect представила Prime Inference — уровень обслуживания для своего стека открытого обучения. Решение поддерживает серверные и зарезервированные конфигурации, позволяя использовать производственные трассировки для дообучения моделей. По данным разработчика, эндпоинт GLM-5.3 демонстрирует 100% аптайм и минимальный уровень ошибок при вызове инструментов.
Стек построен на базе NVIDIA Dynamo, vLLM, Mooncake и FlashInfer. Система использует разделение процессов префилла и декодирования на разные группы GPU, что, согласно тестам, снижает задержку p90 на 40%. Маршрутизация с учетом кэша KV позволяет сессиям оставаться на одном декодере, а Mooncake добавляет второй уровень кэширования в оперативной памяти хоста.
Платформа оптимизирована для агентских задач с целевой скоростью 100 токенов в секунду на пользователя. В ходе тестов система обслуживала 66 сессий на группу префилла при производительности 101 токен в секунду на пользователя. Для предотвращения ошибок при вызове инструментов в Dynamo добавлен структурный тег-билдер, а vLLM использует xgrammar для маскировки некорректных токенов.
Разработка велась совместно с Inferact и NVIDIA, при этом исправления передаются в upstream-проекты. Показатели производительности и сравнение цен с конкурентами были верифицированы по состоянию на 2 октября 2026 года с использованием данных сервиса ComputePrices. Инструмент призван замкнуть цикл между развертыванием моделей и их последующим обучением.



