

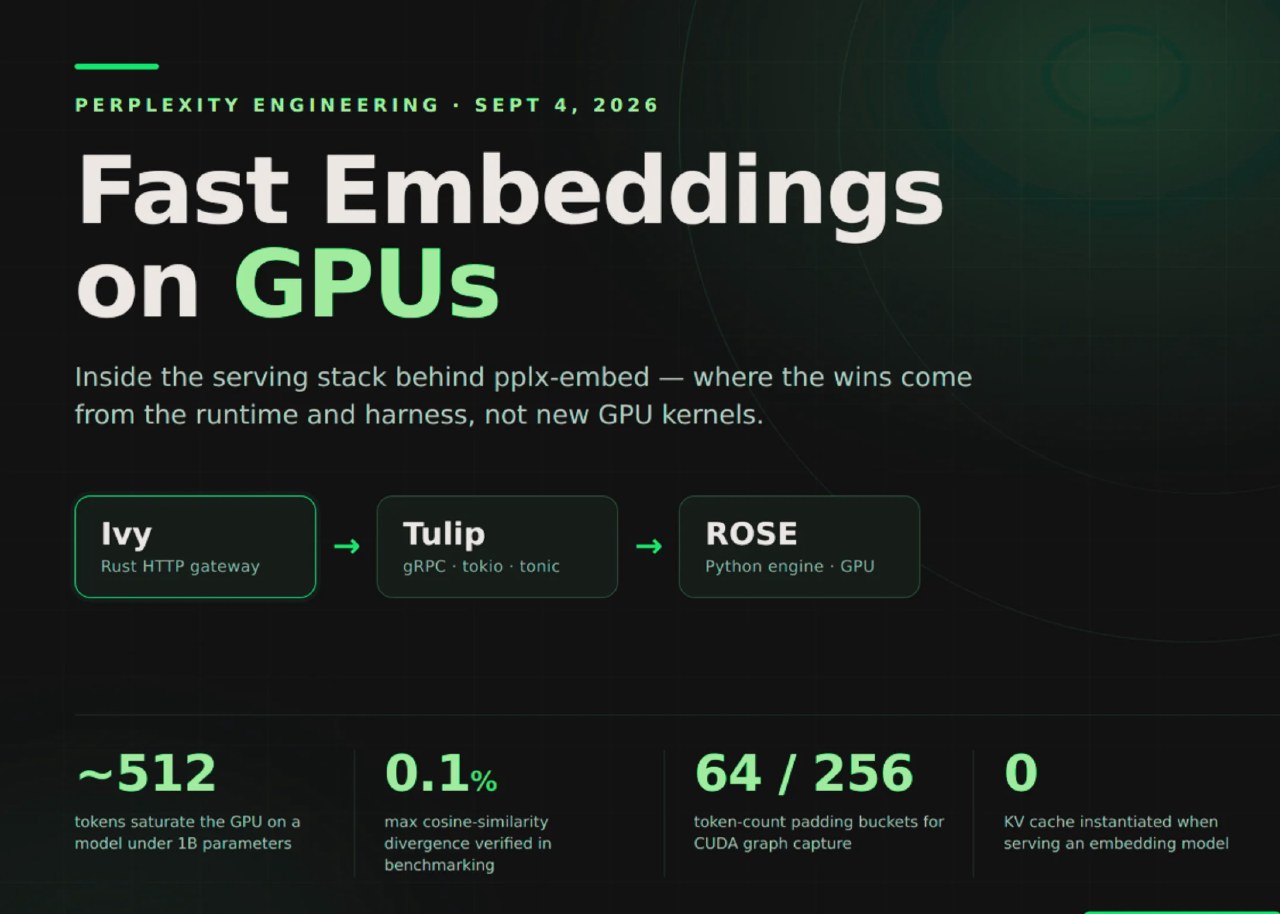
Компания Perplexity раскрыла детали работы своего стека для эмбеддингов, который использует компоненты Ivy, Tulip и ROSE для обслуживания модели pplx-embed. Разработчики решили не создавать отдельный движок, а адаптировать существующие ядра prefill и decode из стека LLM, так как модели эмбеддингов представляют собой небольшие трансформеры.
Планировщик Tulip управляет очередью запросов, при этом Perplexity использует CUDA-графы для всей модели, чтобы снизить накладные расходы на запуск ядер на стороне CPU. Для оптимизации процесса захвата графов применяется метод отложенного захвата: система выполняет прогревочный запуск, а затем активирует захват и повтор при втором обращении, что распределяет нагрузку во времени.
Компонент ROSE поддерживает работу с различными бэкендами внимания, включая FlashInfer 2, FlashInfer 3 и FlashAttention 4, выбирая подходящий вариант в зависимости от модели и длины последовательности. ROSE не создает KV-кэш, чтобы избежать необходимости в паддинге. Также внедрена абстракция LazyTensor, позволяющая Rust-задачам обрабатывать пакеты данных без блокировки выполнения на GPU.
Производительность стека была протестирована в сравнении с vLLM версии 0.22.0 в формате BF16. Бенчмарки охватывали четыре сценария: низкую задержку эмбеддингов, низкую задержку ранжирования, высокую пропускную способность и высокую параллельность запросов. В ходе тестов отклонение косинусного сходства не превышало 0,1 процента.



