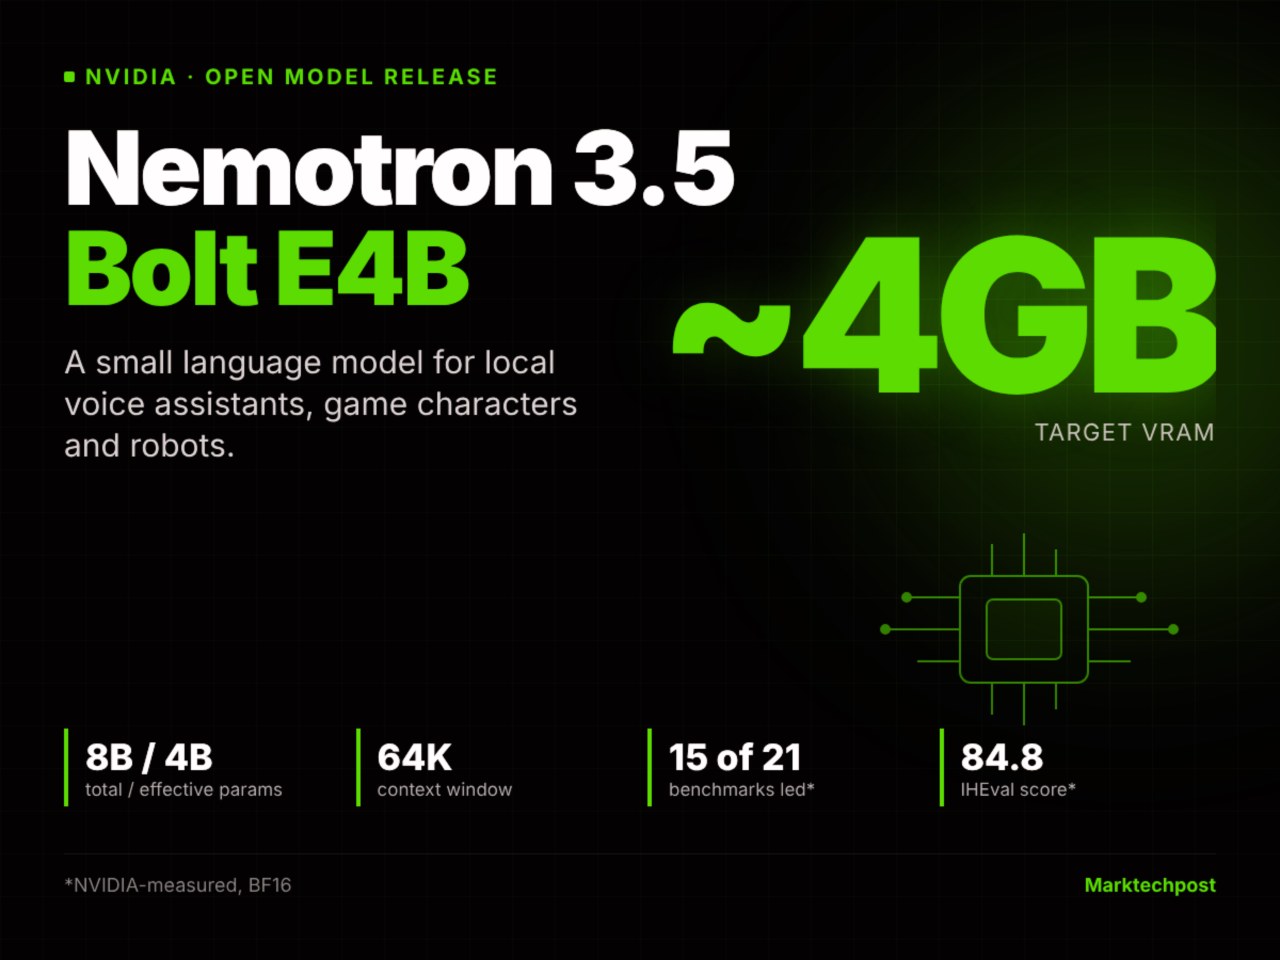
Компания NVIDIA представила Nemotron 3.5 Bolt E4B — компактную языковую модель для локальных голосовых помощников, игровых персонажей и промышленных роботов. Модель поддерживает многоходовые вызовы инструментов.
При обучении разработчики отказались от контролируемой донастройки в пользу методов RLVR и RLHF через инструменты NeMo-RL и NeMo-Gym. В процессе обучения соблюдалось соотношение 2:1 между нерассуждающими и рассуждающими выборками.
Для развертывания модель квантуется до формата Q4_K_M. При использовании DFlash для спекулятивной декодировки на видеокарте RTX 5070 скорость работы достигает 272,6 токена в секунду, что на 21% быстрее Gemma 4 E4B.
По внутренним тестам NVIDIA, Bolt превосходит Nemotron 3 Nano 4B на 40% по средним показателям. Модель лидирует в 15 из 21 категории, однако уступает Qwen3.5-4B в тестах Tau2-Bench, RULER 64K и LongBench v2.
Модель доступна на платформах Hugging Face, Ollama, LM Studio, Unsloth и Jetson AI Lab. Также предусмотрена интеграция через NVIDIA NIM и SDK для игровых вычислений.