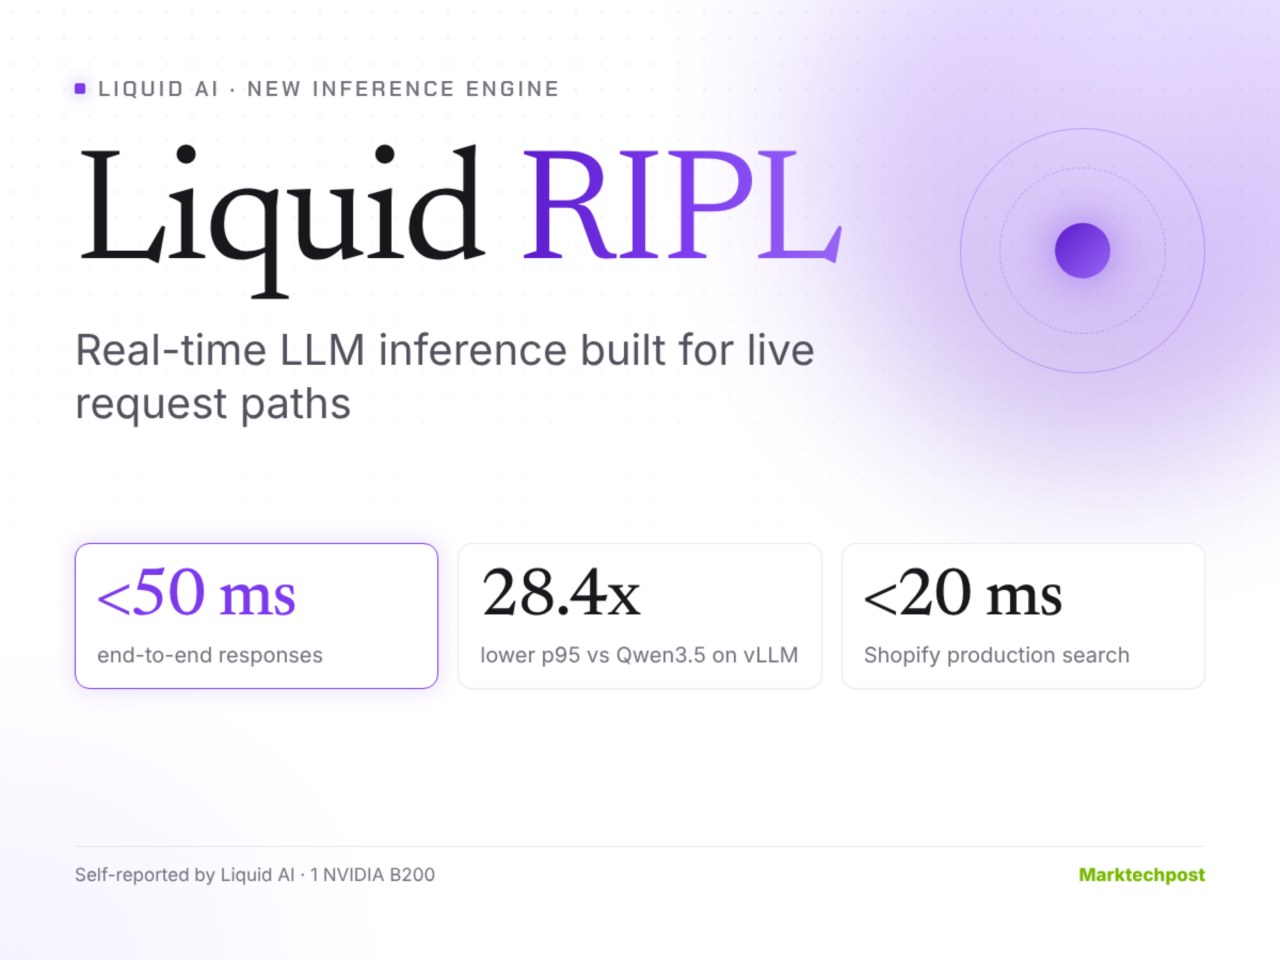
Компания Liquid AI представила движок RIPL для работы с моделями Liquid Foundation Models (LFM) с задержкой менее 50 мс. Решение оптимизирует путь запроса от поступления до получения ответа, что позволяет использовать нейросети в задачах ранжирования поиска, проверки платежей и выявления мошенничества.
Тестирование модели LFM2.5-350M на одном графическом процессоре B200 показало, что RIPL обеспечивает более низкие показатели задержки p95 по сравнению с фреймворком vLLM. В качестве сравнения использовались модели MiniCPM5 и Granite 4.2, работающие на vLLM.
Гибридная архитектура моделей LFM2.5 включает различные конфигурации слоев. Версия LFM2.5-1.2B-Instruct состоит из 16 слоев, включая 10 сверточных блоков и 6 блоков GQA. Модель LFM2.5-2.6B содержит 30 слоев: 22 сверточных блока и 8 блоков GQA.
Компания Shopify внедрила LFM в свои торговые системы. В задачах улучшения поиска время инференса на реальном трафике составляет менее 20 мс. По данным Liquid AI, эти модели используют на 50% меньше параметров, чем аналоги, и работают в 2–10 раз быстрее.