

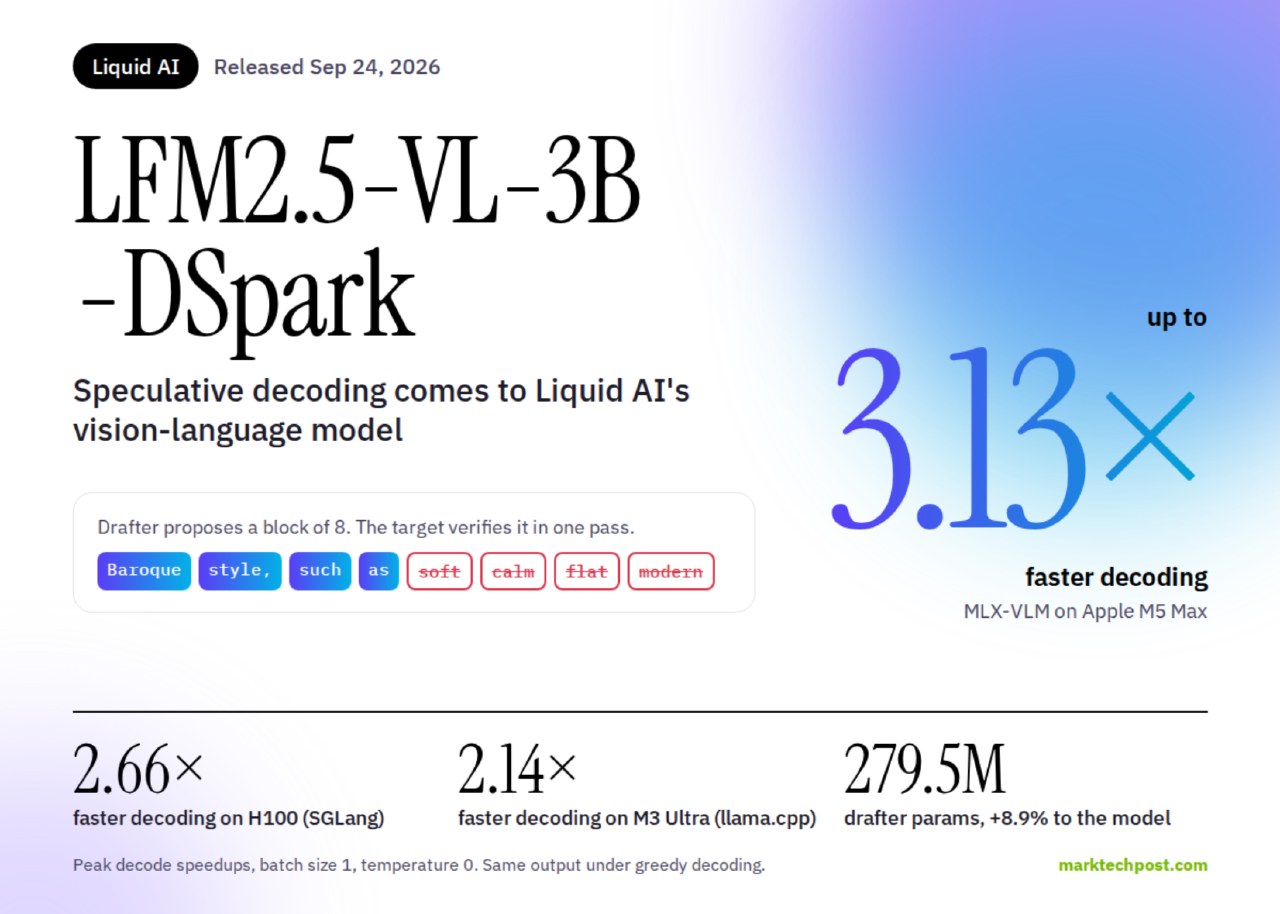
Компания Liquid AI представила экспериментальную модель LFM2.5-VL-3B-DSpark с поддержкой спекулятивного декодирования. Веса модели доступны на Hugging Face в форматах Safetensors и GGUF. Программное обеспечение поддерживает работу через SGLang, MLX-VLM и llama.cpp. Лицензия LFM Open License v1.0 разрешает бесплатное коммерческое использование для компаний с годовой выручкой менее $10 миллионов.
Архитектура DSpark использует вспомогательную модель-черновик, которая предсказывает несколько токенов за раз. Система работает с размером блока 8 или 9, что увеличивает количество параметров на 8,9%. Обучение проводилось на оборудовании AMD в течение 10 эпох. Эффективность модели оценивалась по бенчмарку MMSpec, включающему шесть категорий задач, таких как визуальные вопросы-ответы и описание изображений.
Тесты на чипах M5 Max показали ускорение декодирования до 3,13 раза и общее ускорение до 2,62 раза. При использовании графических процессоров H100 модель также демонстрирует преимущество по пропускной способности. Разработчики отмечают, что эффективность спекулятивного декодирования зависит от рабочей нагрузки и температуры: при высоких значениях температуры частота принятия предложенных токенов снижается.
Для запуска требуются актуальные версии библиотек: SGLang версии 0.5.19 или новее, а также MLX-VLM версии 0.7.2 или новее. В текущей реализации MLX-VLM поддерживает только жадное декодирование. В llama.cpp предусмотрена возможность совместного использования GGUF-версий черновика и основной модели. Ускорение квантованных моделей в данный релиз не включено.



