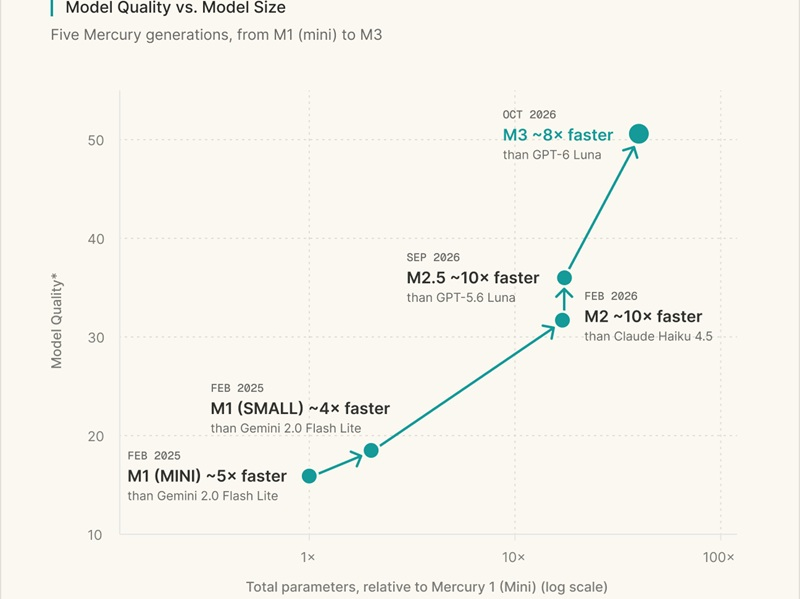
Компания Inception из Редвуд-Сити представила диффузионную языковую модель Mercury 3. Она в 40 раз больше своей предшественницы, Mercury 1, при этом скорость её работы превышает 1000 токенов в секунду.
В отличие от стандартных моделей, генерирующих текст последовательно, диффузионная архитектура Mercury 3 позволяет выдавать несколько токенов одновременно. Контекстное окно модели расширено до 1 миллиона токенов.
По внутренним тестам, Mercury 3 превосходит GPT-6 Luna, Claude Haiku 5.5 и GLM-5.3 Flash, работая при этом в 4–8 раз быстрее. Генеральный директор Стефано Эрмон заявил, что ответы приходят почти мгновенно.
Mercury 3 стала четвертой моделью в линейке с июня 2025 года. Она доступна через Inception API, Baseten, OpenRouter и Vercel, а благодаря совместимости с API OpenAI разработчики могут интегрировать её без переписывания кода.
Стоимость использования составляет $0,2 за миллион входных и $0,7 за миллион выходных токенов. На этапе запуска Inception снизила цены вдвое — до $0,1 и $0,35 соответственно.