

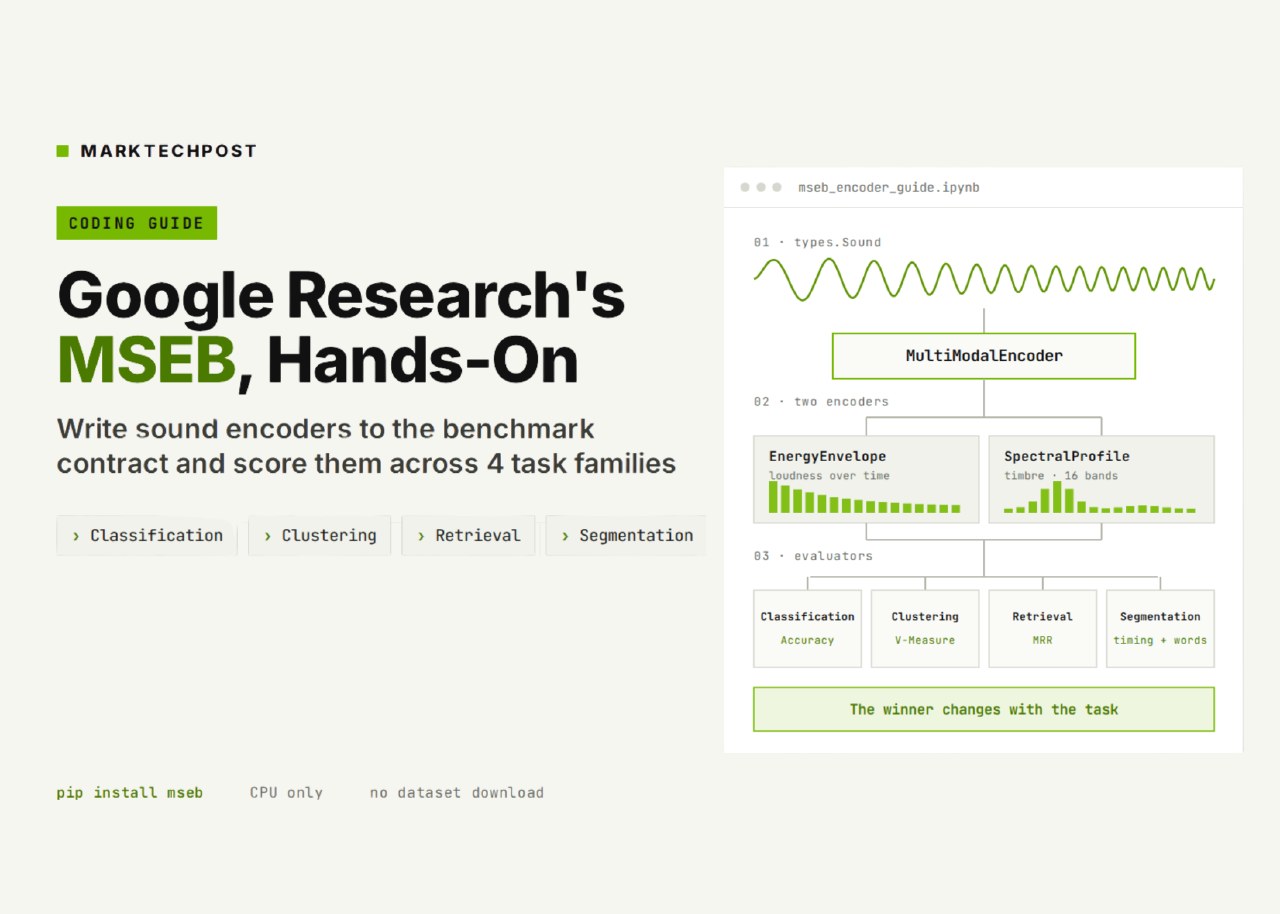
Google Research представила бенчмарк MSEB для оценки аудиомоделей. Система состоит из трех уровней: types (определяет структуру данных), encoder (интерфейс для реализации моделей) и evaluators (модули для задач классификации, кластеризации, поиска и сегментации).
Для интеграции модели разработчики создают подкласс MultiModalEncoder. Он требует реализации трех методов: _setup для инициализации, _check_input_types для проверки входных данных и _encode для обработки пакетов аудио. Фреймворк автоматически рассчитывает статистику кодирования, включая показатели сжатия и количество операций FLOP.
Бенчмарк поддерживает работу с синтетическими данными, что позволяет проводить тестирование на CPU без загрузки внешних датасетов. Легкие задачи используют библиотеки NumPy и scikit-learn, в то время как более сложные процессы, такие как транскрипция, могут задействовать сторонние инструменты, включая Whisper, TensorFlow и Apache Beam.
Система типов MSEB строго регламентирует передачу данных. Объекты Sound содержат аудиосигнал и контекст, а SoundEmbedding — векторы и временные метки. Объекты Score автоматически проверяют корректность метрик, таких как точность, что исключает попадание некорректных данных в итоговый рейтинг.



