

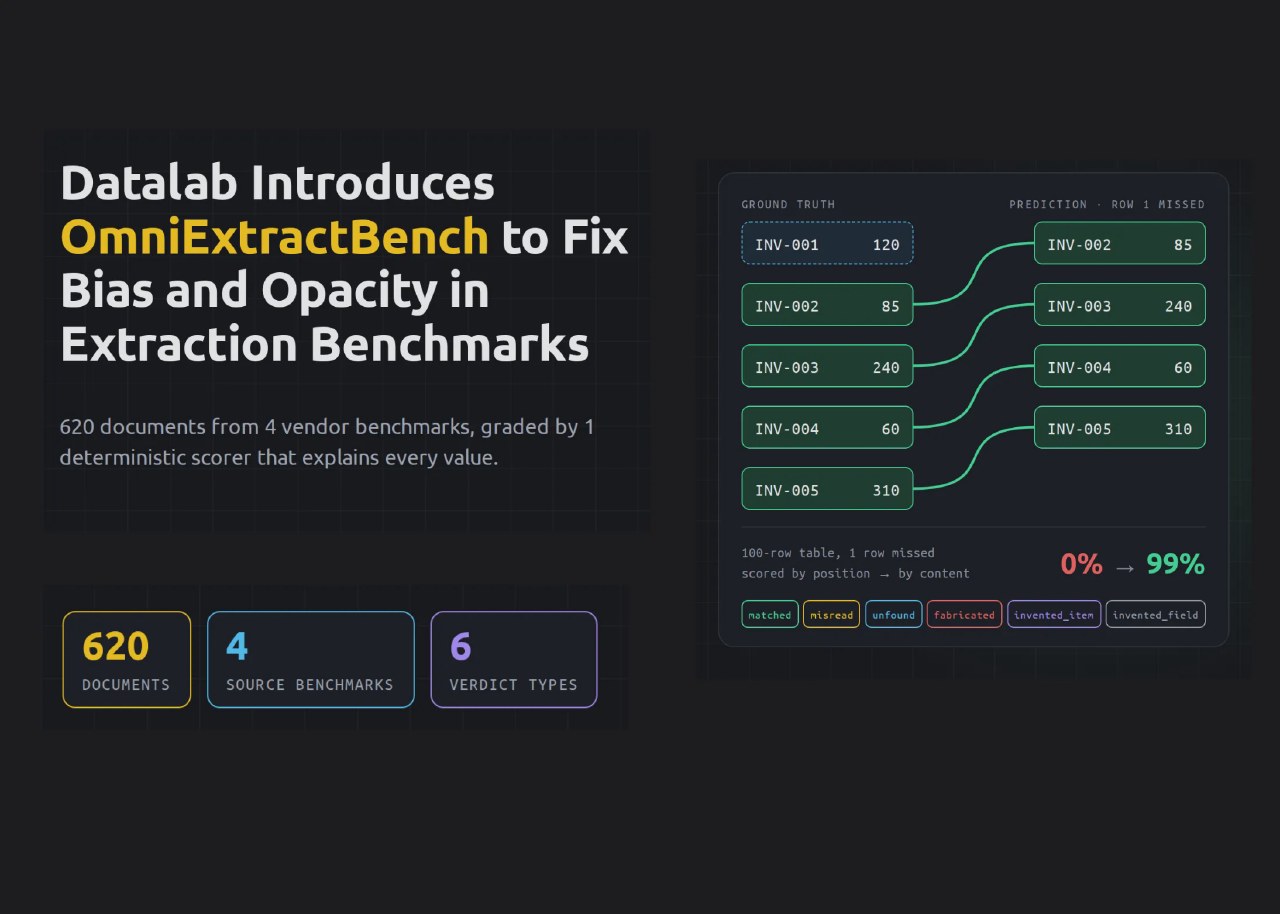
Компания Datalab представила OmniExtractBench — инструмент для оценки качества извлечения структурированных данных из документов. Разработчики создали этот бенчмарк, чтобы устранить предвзятость и непрозрачность, характерные для существующих отраслевых рейтингов, которые сложно аудировать.
Система работает путем сравнения JSON-ответов модели с эталонными файлами. Для обработки таблиц, где пропуск одной строки может исказить результат, используется алгоритм Венгерского метода. Инструмент нормализует значения, позволяя сопоставлять разные форматы данных, например, даты в различных записях.
Пакет доступен в репозитории PyPI под версией 0.1.7, требует Python 3.11 и выше. Код распространяется по лицензии Apache 2.0, данные размещены на платформе Hugging Face. Для запуска тестов сторонних систем пользователям необходимы собственные API-ключи и оплаченные кредиты.
В ходе тестирования 10 конфигураций систем Datalab показала точность 93,85% в режиме accurate. Модели Datalab balanced и Reducto deep_extract v2 продемонстрировали схожие результаты — 93,48% и 93,47% соответственно. Бенчмарк также рассчитывает показатели precision и recall для анализа ошибок.



