

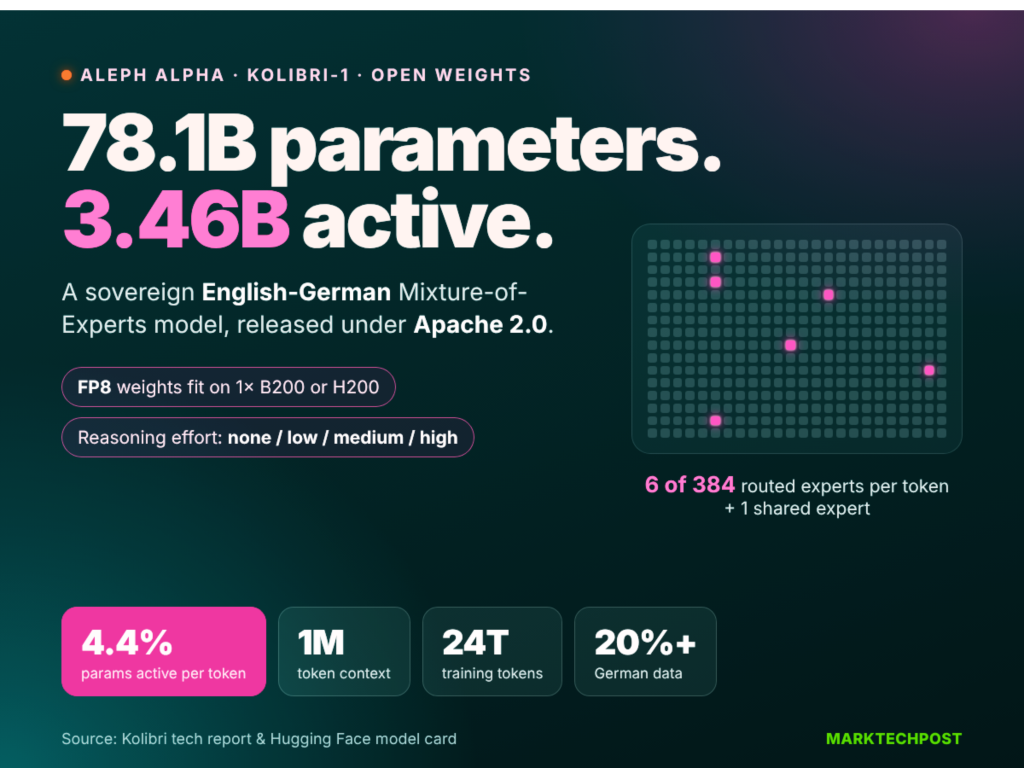
Компания Aleph Alpha представила языковую модель Kolibri-1. Это двуязычная MoE-модель для английского и немецкого языков с общим числом параметров 78,1 миллиарда и 3,46 миллиарда активных параметров. Модель использует 50 трансформерных блоков и словарь на 128 000 токенов, обученный через UniBPE, что повышает эффективность обработки немецкого текста на 11,2% относительно токенизатора GPT-5.
Архитектура модели сочетает разные типы внимания. В 40 блоках применяется скользящее окно на 512 токенов, а каждый пятый блок использует полное внимание без позиционного кодирования. Такой подход позволяет поддерживать последовательности в четыре раза длиннее, чем у моделей с полным вниманием при сопоставимых вычислительных затратах.
Обучение проходило на 768 графических процессорах NVIDIA B200 и включало 20 триллионов токенов на этапе претрейна, 3,44 триллиона на промежуточном этапе и 201 миллиард токенов для длинного контекста. Посттрейн включал обучение с подкреплением на более чем 1,2 миллиона внутренних задач с использованием протокола Merlin-Arthur.
Чекпоинт FP8 занимает около 78 ГБ и работает на GPU NVIDIA B200, B300, H200 или паре H100 SXM5 через vLLM. Стандартное окно контекста составляет 262 144 токена, с возможностью расширения до 1 миллиона токенов через настройки. Разработчики рекомендуют использовать температуру 1.0, top-p 0.97 и top-k 128.



