

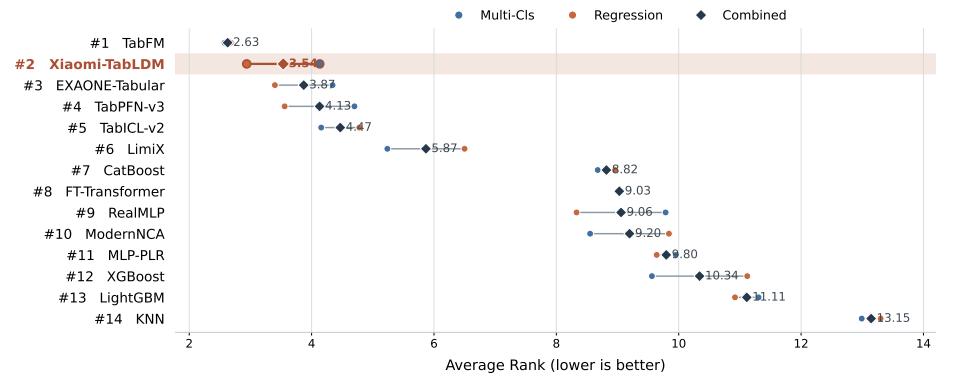
Компания Xiaomi представила модель TabLDM, предназначенную для работы с табличными данными без необходимости дообучения под конкретные задачи. Разработчики выпустили две версии: классификатор на 70 млн параметров и регрессор на 71 млн. Для повышения точности прогноза модель по умолчанию выполняет восемь прогонов с разным перемешиванием признаков и предобработкой данных.
Архитектура решения состоит из трех этапов: кодирование групп столбцов через Set Transformer, формирование вектора строки и обработка данных в контексте обучающих примеров. В последних восьми блоках применяется смесь экспертов, где для каждого токена выбирается один из двух маршрутизируемых или общий эксперт. Для ускорения работы предусмотрен KV-кэш, а данные можно хранить в RAM или на диске.
В рейтинге TabArena модель набрала 1900 очков Elo, уступив TabFM с 2019 очками. В общем зачете по 51 набору данных TabLDM заняла четвертое место с 1659 очками, расположившись рядом с AutoGluon 1.5 (1662 очка) и TabPFN-3 (1650 очков). По данным Xiaomi, этап обучения проходит на 82% быстрее, чем у TabFM, а процесс предсказания — на 68% быстрее.
Модель поддерживает таблицы размером от сотен до десятков тысяч строк и от нескольких до более чем ста столбцов. Существуют ограничения: время инференса растет квадратично в зависимости от объема данных, что увеличивает вычислительные затраты при росте таблицы. Модель доступна для использования и модификации под лицензией Apache 2.0.



