

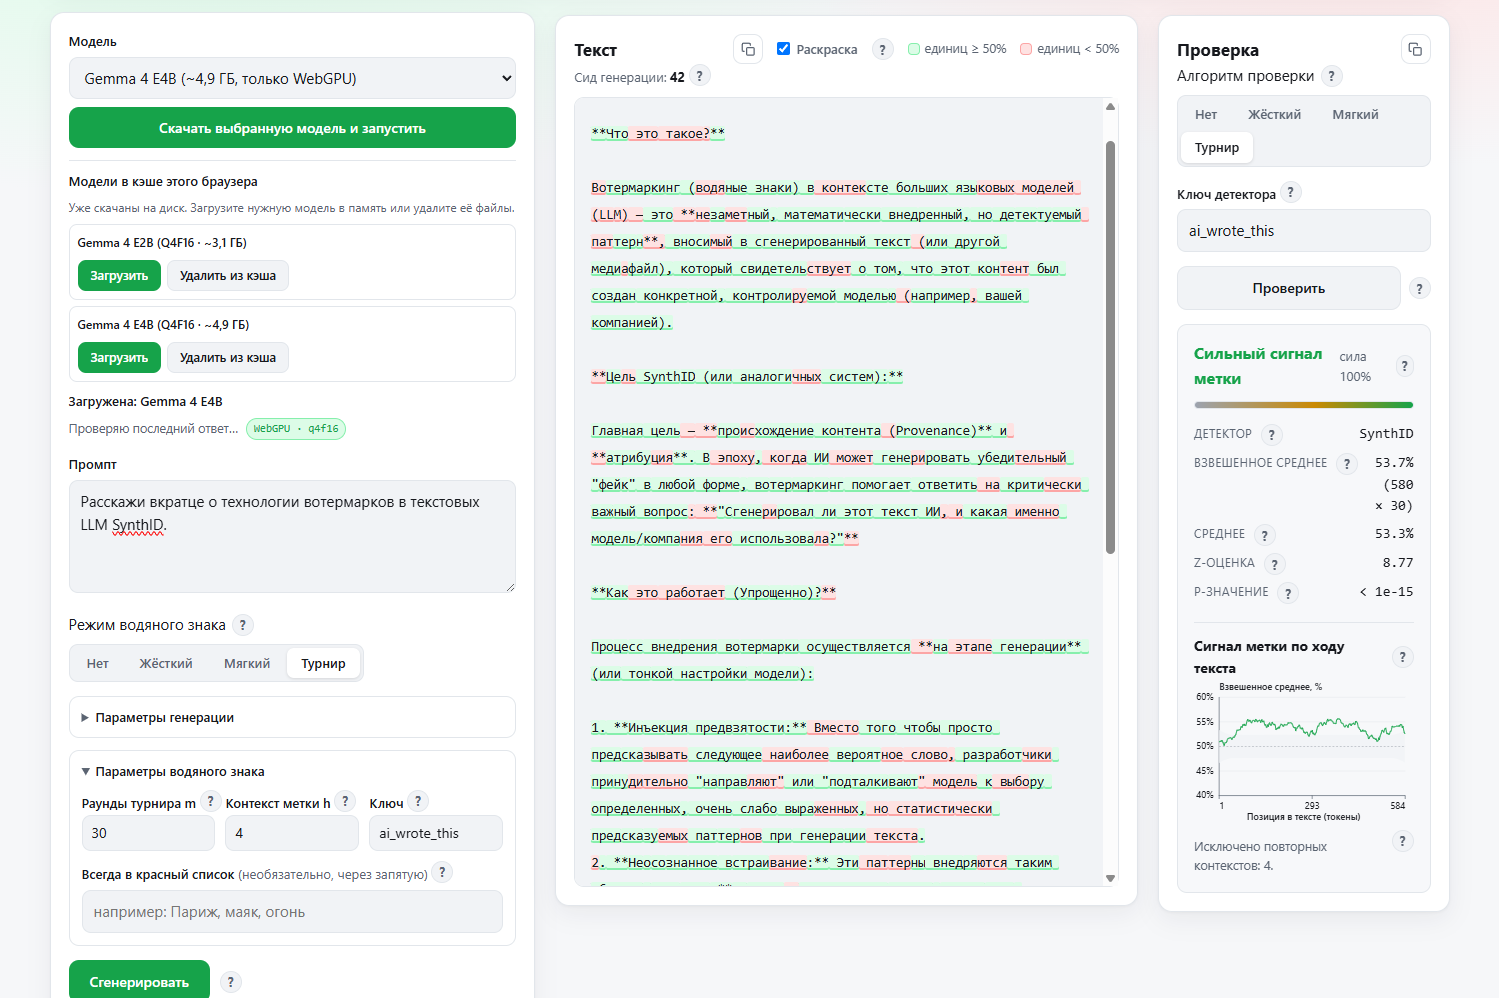
Разработчики крупных языковых моделей внедряют системы водяных знаков в свои продукты. Claude уже использует данную технологию, а OpenAI находится в процессе интеграции подобных меток в вывод своих моделей.
Наличие водяных знаков вызывает вопросы у пользователей, работающих с отчетами, научными работами и авторскими текстами. Существуют опасения, что будущие детекторы смогут однозначно идентифицировать контент, созданный нейросетями.
В качестве метода удаления меток предлагается перефразирование текста с помощью других моделей. Однако остается неясным, какой объем правок необходим для обхода детекторов и не приведет ли использование второй нейросети к наложению дополнительных водяных знаков.
Открытым остается вопрос о способах маркировки программного кода. Неизвестно, как именно водяные знаки размещаются в коде: в комментариях, именах переменных или синтаксических конструкциях.



