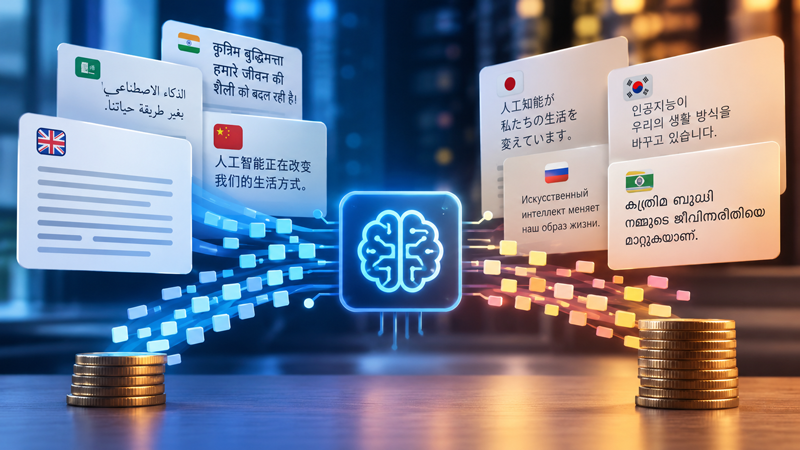
Исследователи из Коалиции за языковое равенство в исследованиях ИИ (CLEAR) выявили проблему «налога токенизатора». Она заключается в том, что алгоритмы разбивают текст на разное количество токенов в зависимости от языка, что напрямую влияет на стоимость использования коммерческих ИИ-сервисов.
Анализ на основе корпуса FLORES-200 показал, что для 20 наиболее популярных языков разница в количестве токенов составляет от 1,5 до 5 раз. При расширении выборки до 200 языков разрыв для отдельных моделей достигает 17 раз, что делает обработку запросов на редких языках значительно дороже.
Помимо финансовых затрат, проблема ограничивает доступный объём контекста. Поскольку модели имеют фиксированные лимиты токенов, языки, требующие большего количества фрагментов для передачи того же смысла, оставляют меньше места для истории переписки и документов.
Дополнительные токены также увеличивают вычислительную нагрузку и время отклика системы. Наиболее заметные сложности возникают у языков с письменностями, которые слабо представлены в обучающих данных, включая бирманский, тибетский, кхмерский и лаосский языки.
Специалисты предлагают решать проблему через расширение многоязычных обучающих выборок и разработку специализированных токенизаторов для различных письменностей. Авторы исследования подчеркивают необходимость целенаправленных действий со стороны разработчиков ИИ.