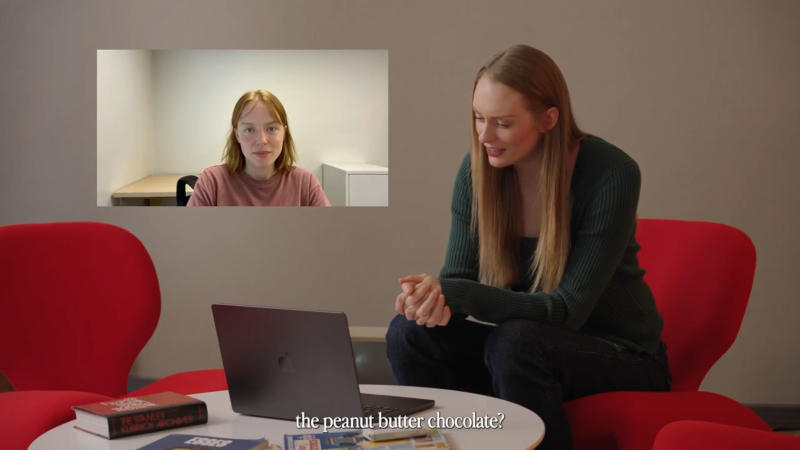
Американский стартап Tavus представил модель Griffin для общения по видеосвязи в реальном времени. В ходе эксперимента 26 из 54 участников, что составляет 48 процентов, приняли виртуального собеседника Griffin-Lite за человека после минутного разговора. Для сравнения, предыдущую систему компании принимали за человека лишь 2,4 процента респондентов, или один из 41 участника.
Griffin использует архитектуру «полнодуплексной системы видео-в-видео», которая заменила последовательную обработку данных. Система непрерывно анализирует аудио- и видеосигналы, что позволяет ей кивать, вставлять реплики и менять выражение лица, не дожидаясь окончания речи пользователя. Оценка состояния диалога происходит с интервалом менее одной секунды.
Модель относится к классу моделей взаимодействия с человеком. Она генерирует видео в разрешении 720p фрагментами по 320 мс и способна клонировать голос по десятисекундной записи. Средняя задержка преобразования звука в видео на процессорах Nvidia H100 составляет 0,43 с. В бенчмарке VideoFDB система получила 3,83 балла за генерацию поведения и 3,73 балла в категории восприятия.
На текущий момент Griffin-Lite доступна ограниченному кругу тестировщиков. Перед широким релизом Tavus планирует внедрить меры безопасности, включая обязательное уведомление собеседника об использовании ИИ. Разработчики предлагают использовать технологию в сферах обучения, подготовки к сложным переговорам и для оказания дистанционной помощи пользователям.