

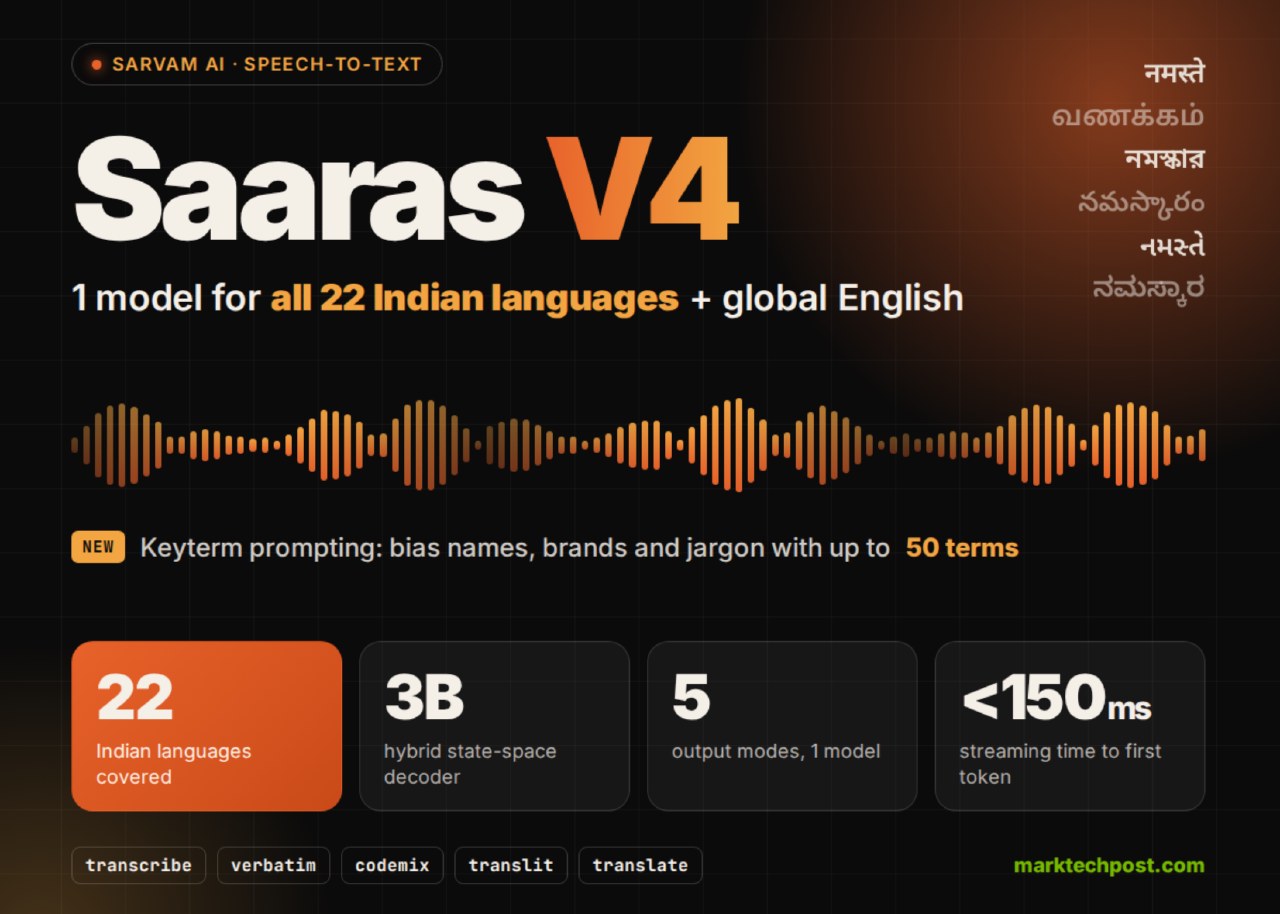
Компания Sarvam AI представила модель Saaras V4 для преобразования речи в текст. Система поддерживает 22 языка Индии и английский язык. Модель доступна для использования через API по идентификатору saaras:v4. Веса модели не находятся в открытом доступе, а документация для самостоятельного размещения на данный момент охватывает только предыдущую версию, Saaras v3.
Архитектура модели основана на системе энкодер-декодер. Аудиоэнкодер преобразует звуковые волны в эмбеддинги, а адаптер временной дискретизации сжимает последовательность для работы с контекстом декодера. В качестве декодера используется Sarvam-3B — гибридная языковая модель с 3 миллиардами параметров, обученная с нуля. Она генерирует транскрипцию, обрабатывая аудио вместе с текстовыми подсказками.
В версии V4 появилась функция ключевых слов. Пользователи могут передать JSON-список до 50 терминов длиной до 64 символов каждый для повышения точности распознавания. Также предусмотрен режим codemix, позволяющий сохранять написание брендов в латинице. Параметр mode позволяет выбирать один из 5 вариантов представления данных.
Согласно данным разработчика, на бенчмарке IndicContextEval модель Saaras V4 показала уровень ошибок (WER) 16,03% в режиме L5. В Sarvam AI заявляют, что это самый низкий показатель на данном тесте. Компания подчеркивает, что все приведенные цифры являются внутренними отчетами и на текущий момент не прошли независимую проверку сторонними исследователями.
Saaras V4 использует ту же структуру запросов, что и Saaras v3, поэтому переход на новую версию требует изменения одной строки кода. Разработчики отмечают, что выполнение всех операций внутри модели позволяет отказаться от этапов постобработки, которые могут приводить к накоплению ошибок при распознавании речи.



