

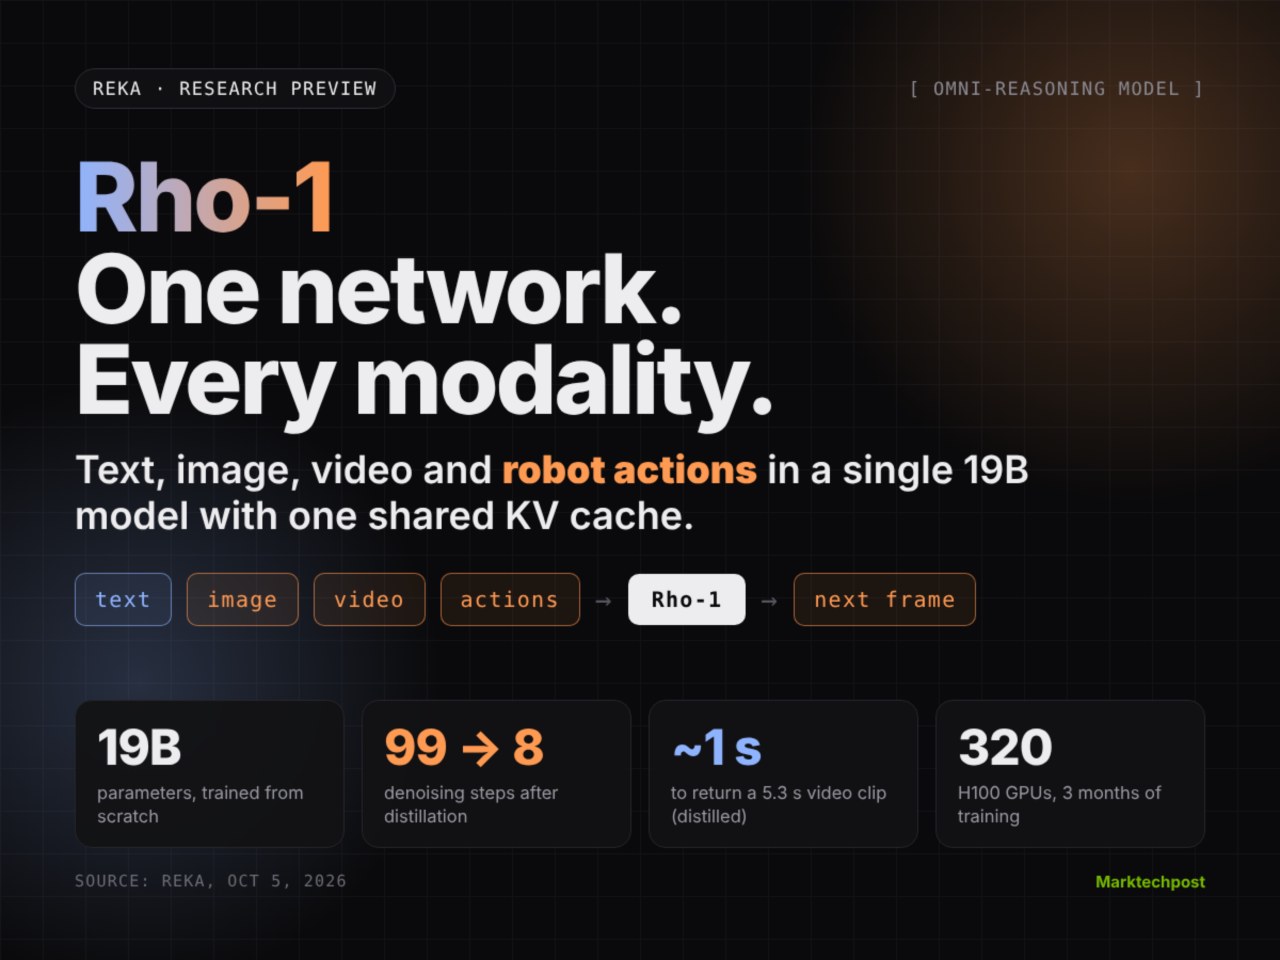
Компания Reka представила Rho-1, мультимодальную модель с 19 миллиардами параметров, способную обрабатывать текст, изображения, видео и команды для робототехники в рамках одного контекстного окна. В отличие от систем, использующих цепочки специализированных моделей, Rho-1 объединяет все функции в единой архитектуре, что снижает задержки при выполнении задач.
Архитектура модели включает блоки с двумя потоками весов экспертов: один отвечает за понимание языка и визуальный анализ, другой — за генерацию изображений и видео. Оба потока используют общие механизмы внимания и кэш KV, что позволяет модели формировать результат на основе накопленного состояния без привлечения дополнительных инструментов.
Согласно внутренним тестам Reka, базовая версия модели генерирует видео со скоростью 0,79 от реального времени, а первый фрагмент появляется примерно через 7 секунд. Дистиллированный вариант модели сокращает количество шагов шумоподавления с 99 до 8, что позволяет создавать 5,3-секундный видеоролик примерно за 1 секунду.
В задачах робототехники Rho-1 декодирует действия и будущие кадры из единого латентного состояния. В симуляции LIBERO модель продемонстрировала генерацию 7 каналов управления. Для масштабирования обучения на ограниченных данных телеоперации Reka применяет модель обратной динамики, которая выводит сигналы управления непосредственно из исходного видео.



