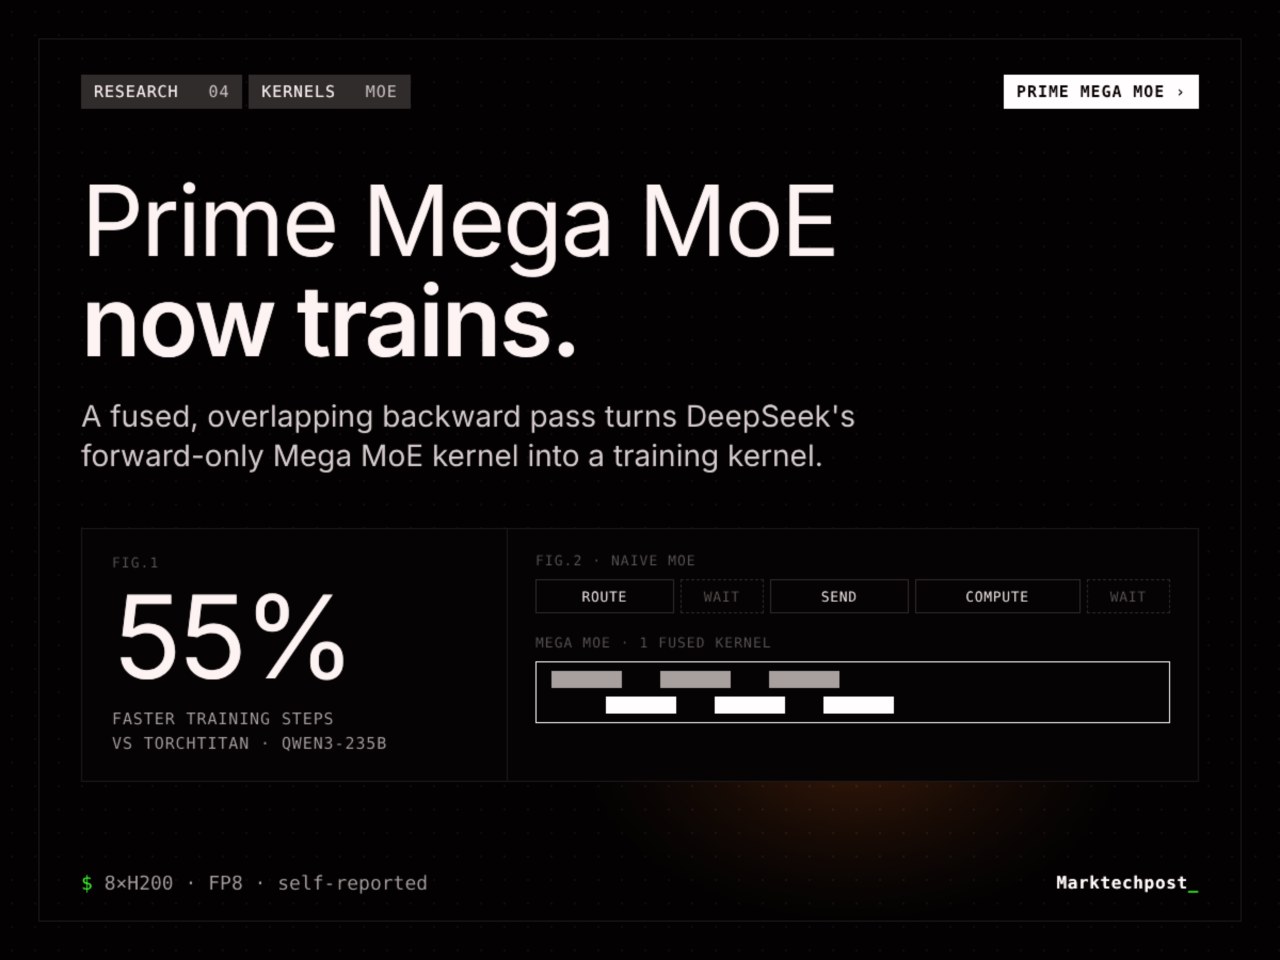
Компания Prime Intellect представила Prime Mega MoE — ядро для обучения моделей Mixture-of-Experts (MoE). Разработка базируется на ядре Mega MoE из библиотеки DeepGEMM от DeepSeek, выпущенной в апреле 2026 года.
Новое решение объединяет операции диспетчеризации, линейные слои экспертов, SwiGLU и комбинирование в один вызов. Система использует буферы только для GPU и совмещает передачу данных с вычислениями, что сокращает время простоя процессоров. Prime Intellect дополнила библиотеку недостающим ядром для обратного прохода.
Поддерживаются форматы BF16, MXFP8 для архитектуры Blackwell и блочный FP8 для Hopper. Также доступен режим fp8_bwd, сочетающий BF16 для прямого прохода и FP8 для обратного. Ядра поставляются в составе готового пакета DeepGEMM из репозитория prime-kernels.
Тестирование на узлах 8xH200 с последовательностями по 16 384 токена показало рост производительности. Для модели 30B пропускная способность выросла с 5 337 до 7 886 токенов в секунду на GPU по сравнению с TorchTitan. Для модели 235B показатель увеличился с 1 094 до 1 697 токенов в секунду.
Разработчики заявляют, что скорость прямого прохода может возрастать до 3,11 раза. Для активации функционала в библиотеке prime-rl необходимо указать тип mega_moe в параметрах диспетчеризации и выбрать нужный уровень точности в конфигурационном файле модели.