

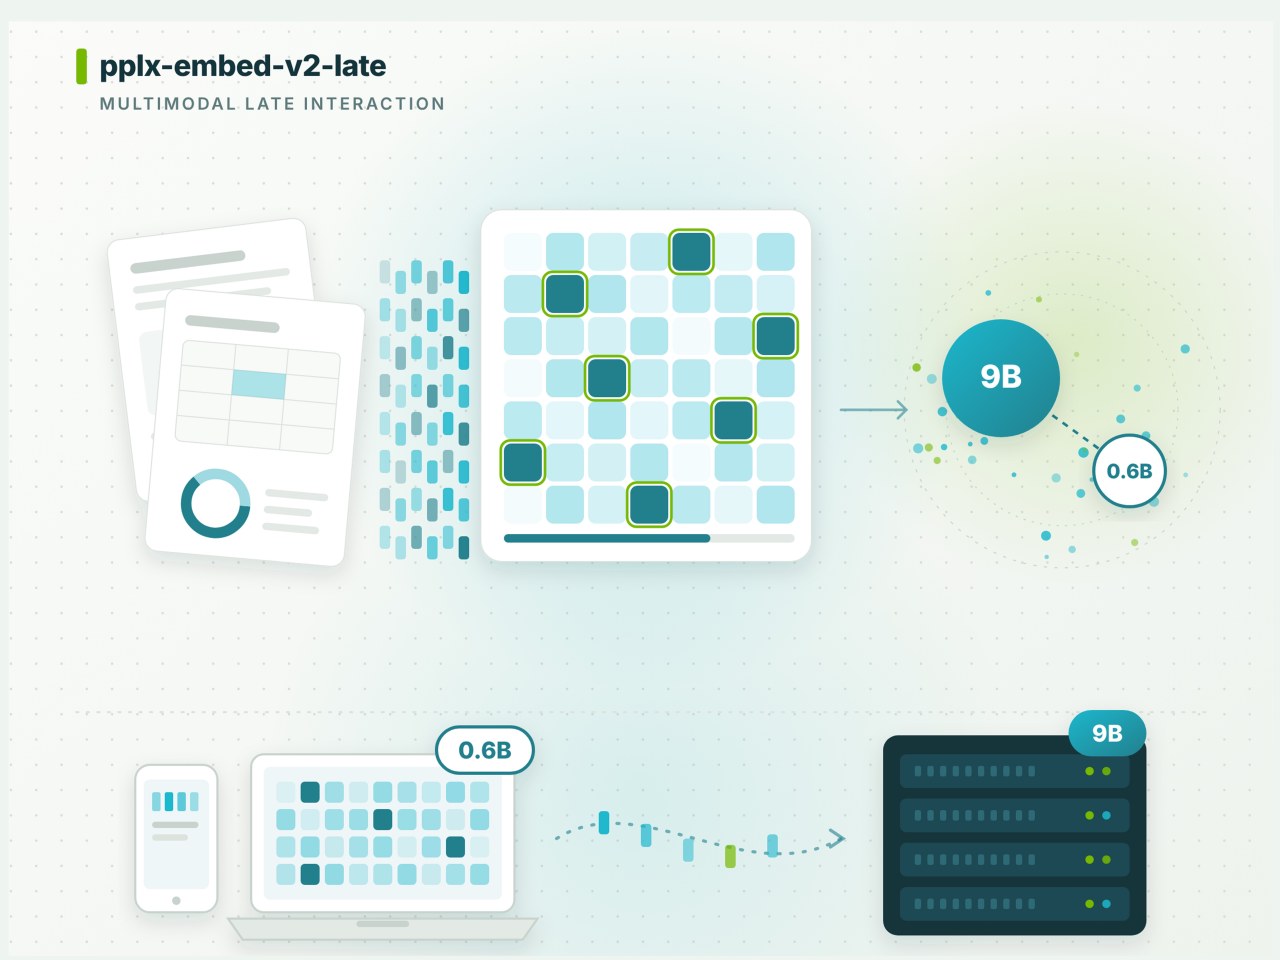
Компания Perplexity AI представила две новые модели эмбеддингов pplx-embed-v2-late: облегченную версию на 0,6 миллиарда параметров для edge-устройств и модель на 9 миллиардов параметров. Обе модели доступны на платформе Hugging Face по лицензии MIT, запуск API-эндпоинта запланирован на будущее.
Модель на 9 миллиардов параметров показала результат 92,4% на бенчмарке MADQA и превзошла лучшие плотные модели на 8,7 процентных пункта в тесте BrowseComp+. Модель на 0,6 миллиарда параметров достигла 61,2% в бенчмарке ViDoRe v3 Markdown, заняв второе место в рейтинге.
Архитектура моделей использует метод MaxSim, сохраняя 128-мерный вектор для каждого токена вместо сжатия документа в один вектор. Это позволяет кодировать страницы как изображения без использования OCR. Обе модели прошли дистилляцию из 18-миллиардной модели-учителя с применением обучения на уровне токенов в стиле LEAF.
Для работы моделей требуются CUDA GPU, библиотека sentence-transformers версии 6.0.0 и выше, а также transformers версии 5.4.0 и выше. Оценочный объем памяти для весов составляет 2 байта на параметр, однако опубликованные чекпоинты представлены в формате F32, что увеличивает размер загружаемых файлов.



