

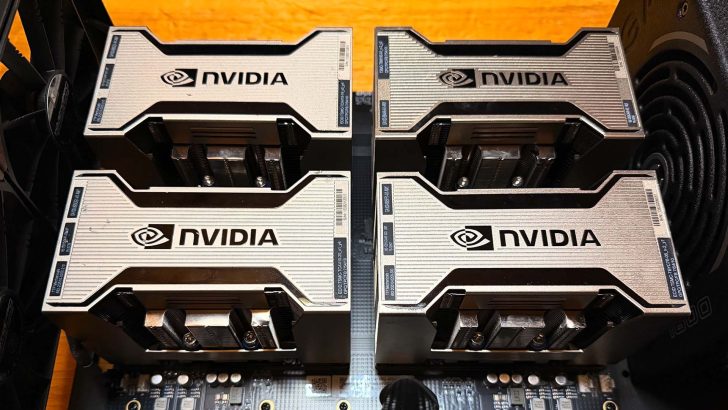
YouTube-канал Jun Yamog протестировал кластер из четырех графических процессоров Nvidia Tesla V100, установленных на плату с поддержкой NVLink. В бенчмарке Qwen3.8-Flash-Next система показала результаты в задачах ИИ-инференса, соревнуясь с двумя устройствами DGX Spark и чипом M5 Ultra.
Tesla V100, выпущенная в 2017 году на архитектуре Volta, оснащена 32 ГБ памяти HBM2 с пропускной способностью 900 ГБ/с. Используемая плата обеспечивает 300 ГБ/с через шесть соединений NVLink 2.0. Для охлаждения каждой карты с энергопотреблением 300 Вт автор теста адаптировал радиаторы от Nvidia A100.
При обработке длинных промптов кластер V100 оказался на 230% быстрее M5 Ultra и на 40% быстрее системы из двух DGX Spark. В тестах с короткими промптами преимущество над DGX Spark составило 40%, а над M5 Ultra — 163%. Автор отмечает, что разрыв с Apple Silicon может быть связан с уровнем программной оптимизации.
В генерации токенов на коротких промптах кластер V100 достиг скорости 100,6 токена в секунду, что на 121% выше показателей DGX Spark. Чип M5 Ultra в этом тесте показал результат 44,5 токена в секунду. Данные тесты подтверждают, что старые серверные GPU сохраняют высокую производительность в специфических задачах инференса.



