

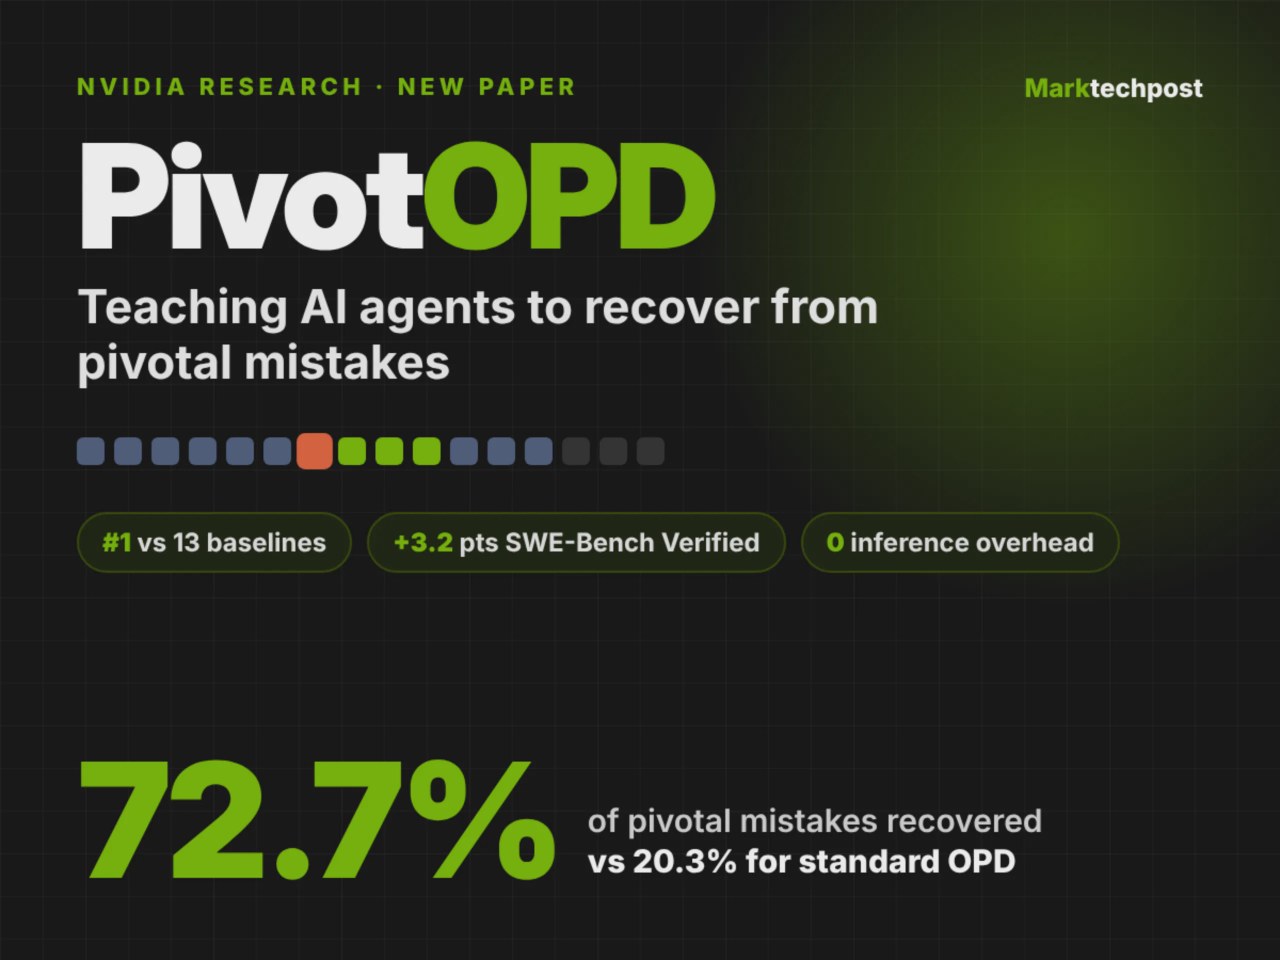
Компания NVIDIA представила метод обучения PivotOPD, который помогает ИИ-агентам исправлять критические ошибки в многоходовых задачах. Под критической ошибкой понимается действие, которое делает выполнение задания невозможным или удлиняет путь к его завершению. Исследование моделей Qwen3 показало, что 59% неудачных попыток содержат такие ошибки, возникающие в среднем на 8–12 ходах из 30.
PivotOPD демонстрирует рост эффективности на различных тестах. При использовании модели с 1,7 миллиарда параметров показатели на ALFWorld достигли 73,7%, а на Search-based QA — 44,5%, что выше результатов методов SDAR и RLSD. Модель с 8 миллиардами параметров показала 93,0% успеха на ALFWorld и 81,9% на WebShop. На SWE-Bench Verified модель Nemotron-3.5-SFT улучшила результат с 62,8% до 66,0%.
Метод показывает высокую способность к восстановлению после ошибок. В серии из 72 повторов критических ситуаций PivotOPD успешно восстанавливался в 72,7% случаев, тогда как базовая модель — в 8,3%, а стандартный OPD — в 20,3%. Среднее время восстановления составило 9,7 хода. Поскольку PivotOPD меняет только процесс обучения, затраты на этапе инференса не увеличиваются.
Накладные расходы при обучении зависят от выбранных параметров. Для модели с 1,7 миллиарда параметров на ALFWorld при использовании 4 графических процессоров H100 избыточность по сравнению с GRPO составляет 12,4% при K=1 и 94,2% при K=2. Бюджет K=2 выбран для ALFWorld, а K=1 — для WebShop и Search-based QA.



