

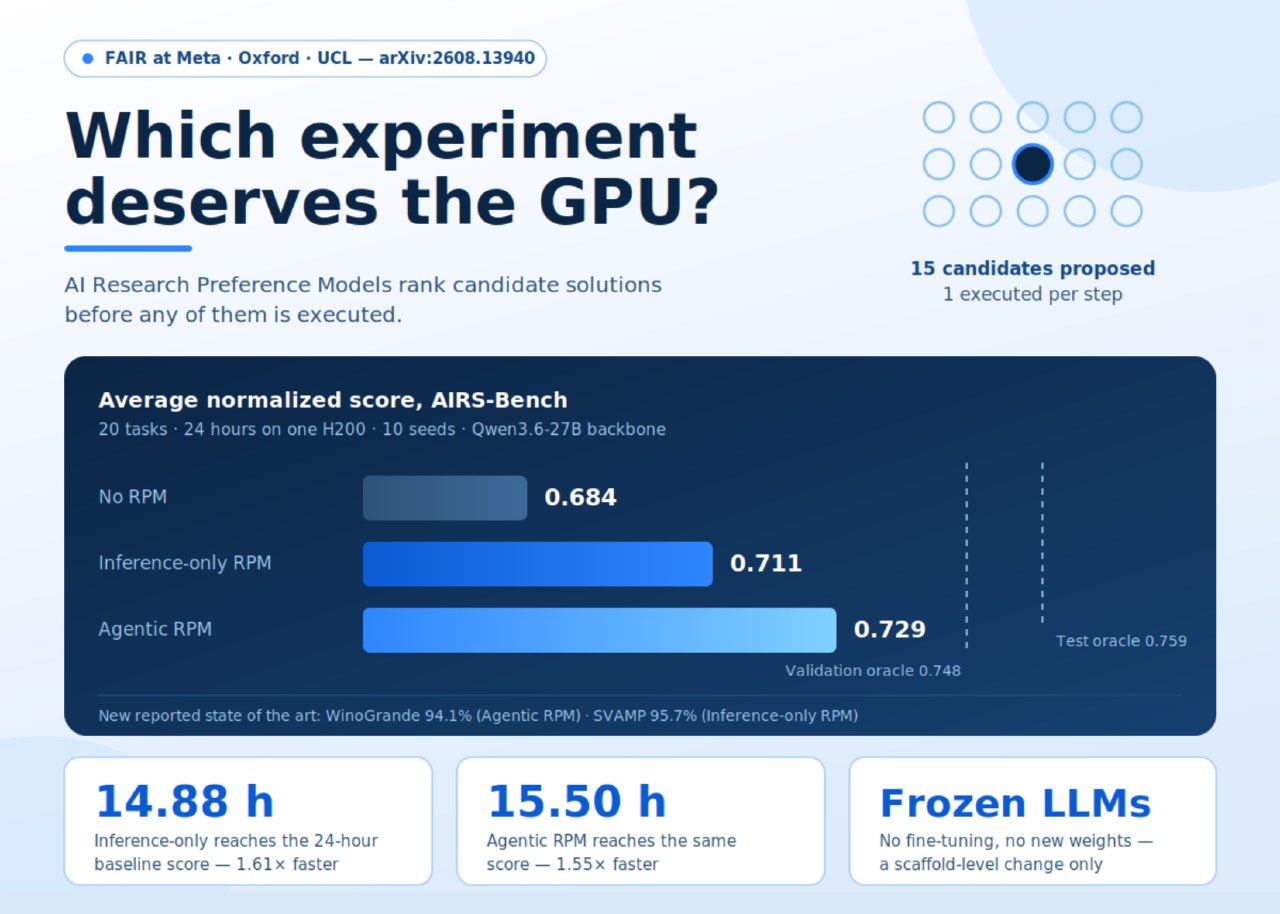
Команда Meta FAIR, Оксфордского университета и Университетского колледжа Лондона представила AI Research Preference Models (RPM). Эти модели предпочтений в исследованиях ИИ позволяют ранжировать варианты экспериментов по машинному обучению до их запуска, чтобы оптимизировать использование GPU-часов.
Система использует замороженные предобученные LLM без дообучения, в качестве основы используется модель Qwen3.6-27B. Скеффолд AIRA-dojo и бенчмарк AIRS-Bench открыты. AIRA-dojo применяет эволюционный поиск по дереву с операторами Draft, Improve и Debug, где RPM selects the winner of a knockout tournament among 15 parallel candidates.
Разработаны две версии: Inference-only RPM, которая работает как LLM-судья над планами и кодом с точностью 57,7–59,0%, и Agentic RPM, Agentic RPM использует песочницу с одним GPU H200. Agentic RPM запускает короткие пилотные эксперименты, количество которых ограничено 30, с порогом в 60 секунд.
Тестирование проводилось на 20 публичных текстовых и табличных задачах, выделяя по 24 часа на одном H200 на каждую задачу. Вероятность улучшения по сравнению с No-RPM составила 0,5923 и 0,5913. С точки зрения эффективности, Inference-only RPM достигла базового показателя 0,684 за 14,88 часа (ускорение в 1,61 раза), а Agentic RPM — за 15,50 часа (ускорение в 1,55 раза).
Метод позволил достичь двух новых SOTA-результатов: 94,1% в WinoGrande, что выше предыдущего агентного SOTA 90,4% от AIRA2, и 95,7% в SVAMP, что выше предыдущего человеческого SOTA 94,2%.



