

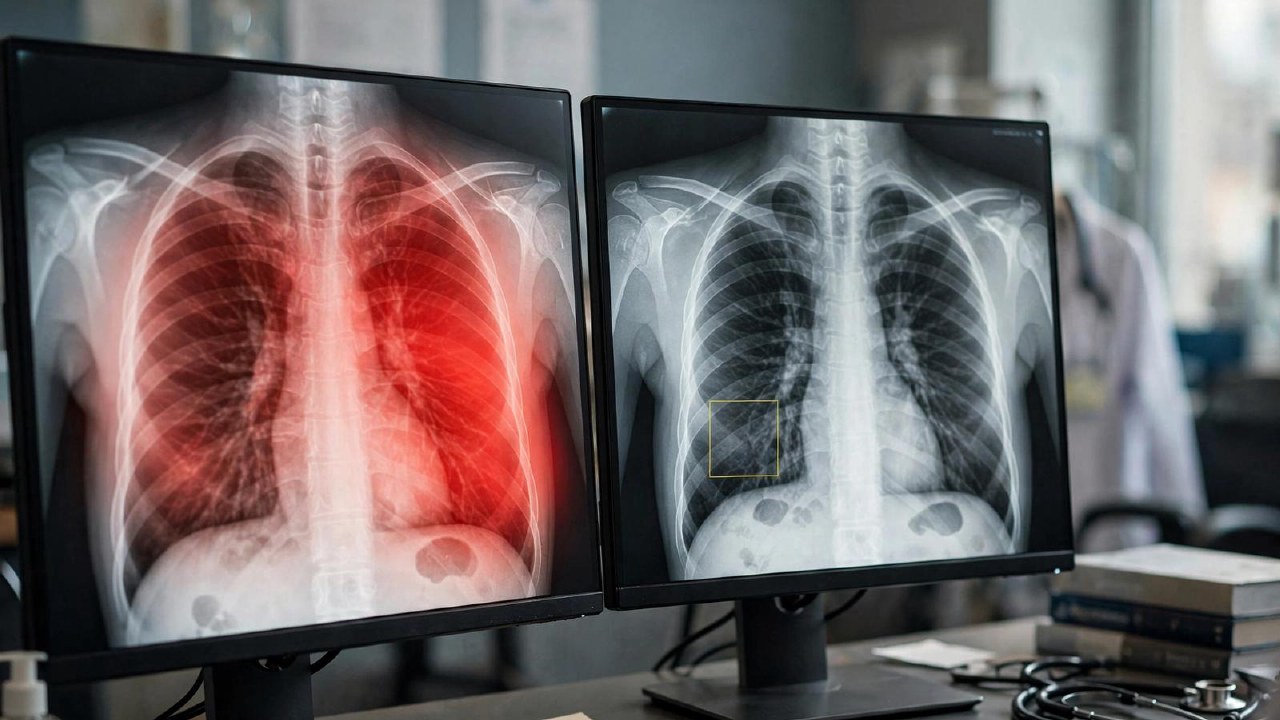
Исследователи из Международного института информационных технологий Хайдарабада (IIIT Hyderabad) провели аудит четырех моделей компьютерного зрения для анализа рентгеновских снимков грудной клетки. В работе сравнили тепловые карты внимания моделей MAIRA-2, MedGemma-4B, LLaVA-Med-1.5 и LLaVA-1.5 с разметками радиологов на трех публичных датасетах и выборке пациентов с пневмотораксом.
Автоматическое сравнение показало, что MAIRA-2 лидирует по качеству совпадения, за ней следуют MedGemma и версии LLaVA. Однако выяснилось, что на типичных случаях точность моделей не превышает показатели простых анатомических шаблонов. ИИ часто подсвечивал области, где патологии встречаются статистически чаще, а не зоны, где они действительно расположены на конкретном снимке.
Только в нетипичных случаях, где находка отличалась от среднестатистической картины, модели MAIRA-2 и MedGemma демонстрировали локализацию, привязанную к изображению. Эксперимент с участием радиологов на 124 случаях подтвердил, что эксперты оценивают тепловые карты иначе: широкая клиническая картина кажется врачам убедительнее, чем строгое попадание в статистические окна.
Авторы исследования рекомендуют внедрять метрики, учитывающие анатомические априорные распределения. Также эксперты настаивают на обязательном привлечении радиологов к оценке работы подобных систем.



