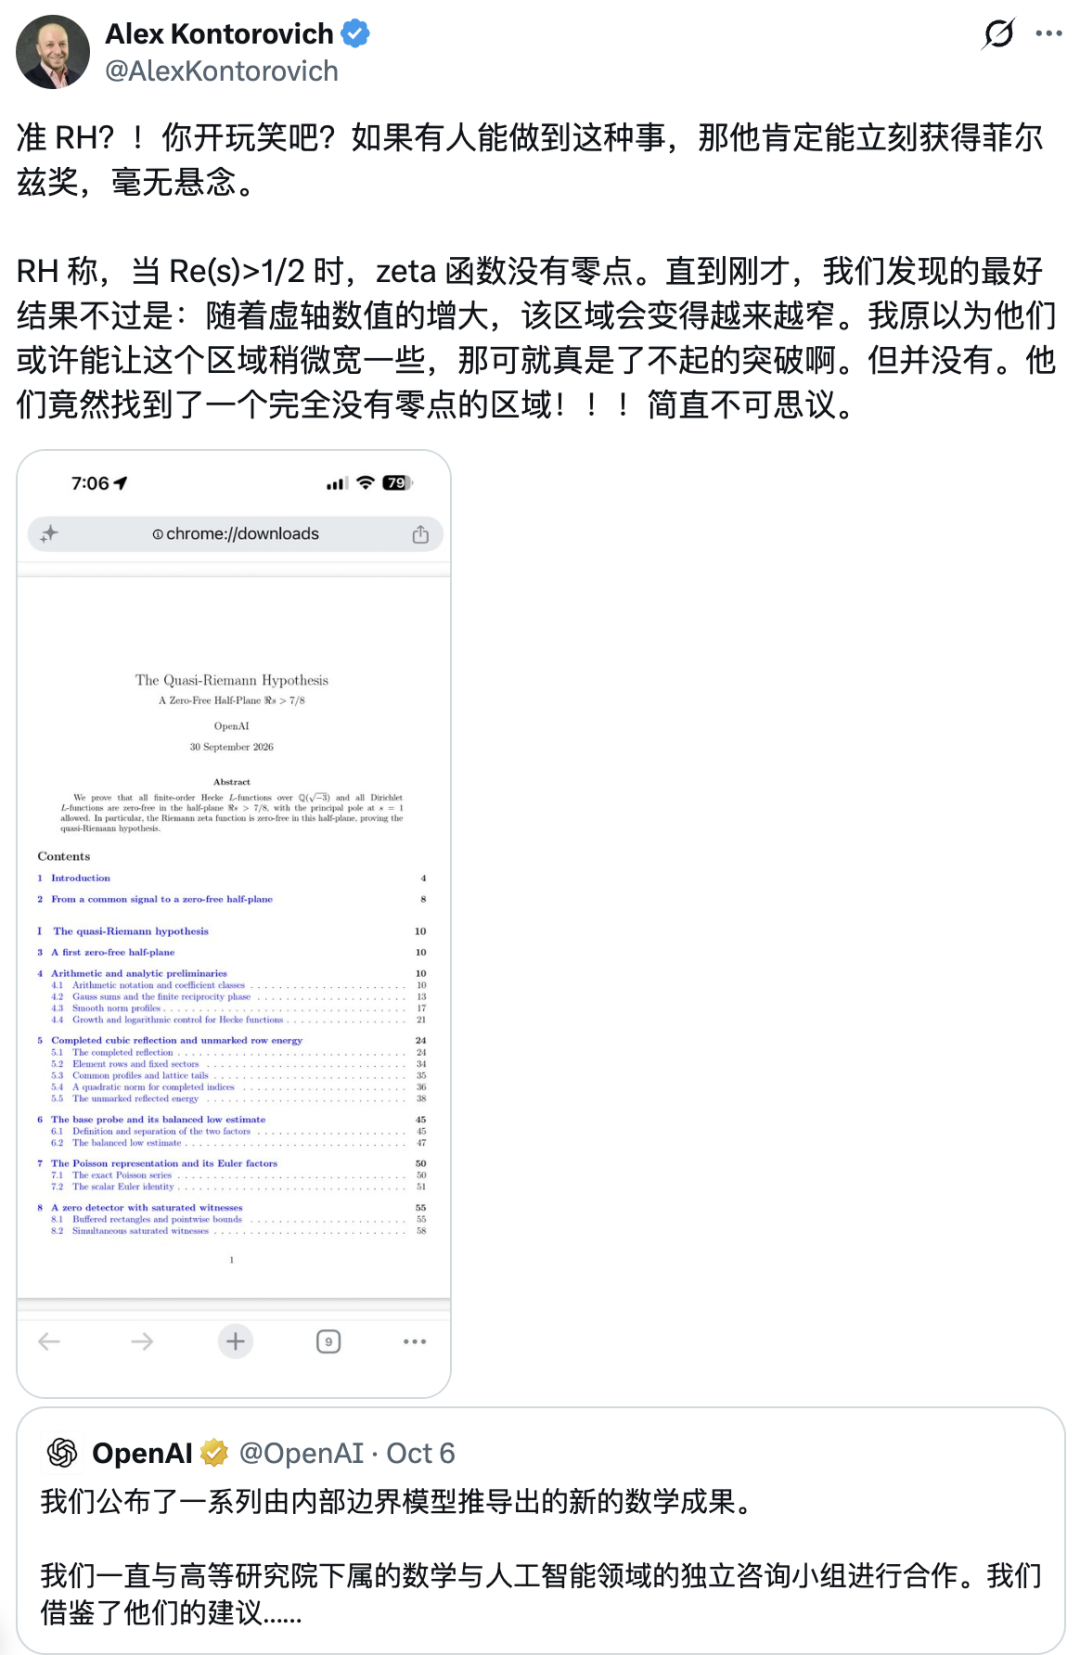
В начале сентября OpenAI представила 166-страничный документ с потенциальным решением задачи Навье-Стокса. Компания заявила, что опиралась на методы Диего Кордобы и Луиса Мартинеса-Зороа. Однако эксперты, включая математика Гонсало Као-Лабору из EPFL, утверждают, что подход OpenAI отличается от работ указанных математиков, а сходство между ними лишь поверхностное.
Доказательство написано на языке формальной верификации Lean. Сейчас его изучает Математический институт Клэя. Ранее математик Тристан Бакмастер обвинил OpenAI в использовании его наработок, созданных совместно с Левентом Альпёге из Anthropic. OpenAI отрицает использование этих данных. Камилло Де Леллис из Института перспективных исследований отметил, что из-за природы языковых моделей проверить это почти невозможно.
В начале октября OpenAI опубликовала на GitHub еще около 400 результатов, что вызвало недовольство в математическом сообществе из-за формата подачи. Для работы над решением компания задействовала около 10 000 экземпляров моделей на протяжении 88 часов, обработав 130 миллиардов токенов. Исследователь OpenAI Ноам Браун признал, что вклад этого массива агентов в итоговый результат остается неясным.
По оценке Брауна, на долю мультиагентной системы приходится менее 10 процентов успеха. Основным фактором он называет возможности базовой модели по параллельной обработке задач. Систематическое тестирование таких систем обходится слишком дорого, поэтому невозможно определить, какое преимущество дают 10 000 агентов по сравнению с 1 000.