

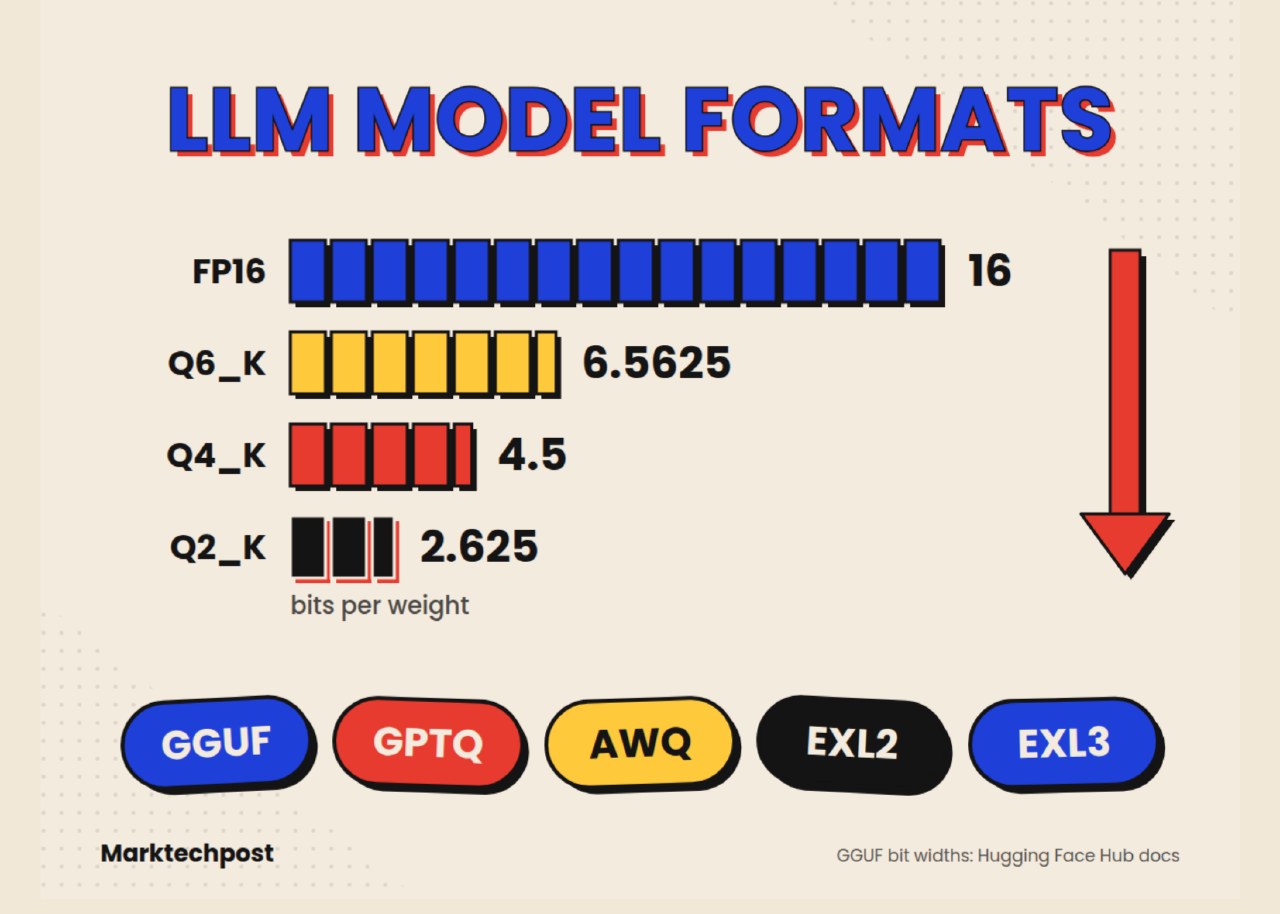
Форматы моделей определяют хранение тензоров, а квантование — сжатие весов. Стандартные модели используют 16-битные веса в файлах .safetensors или .bin. Формат Safetensors, проект PyTorch Foundation, исключает исполняемый код, что повышает безопасность по сравнению с устаревшими файлами на базе pickle.
GGUF, представленный 21 августа 2023 года Георги Гергановым, является основным форматом для llama.cpp. Он позволяет хранить метаданные, токенизаторы и шаблоны чатов в одном файле. Формат поддерживает схемы квантования, такие как Q4_K_M, и калибровку через llama-imatrix. GGUF совместим с Ollama, LM Studio и GPT4All.
Метод GPTQ, представленный на ICLR 2023, использует информацию Гессиана для квантования после обучения. AWQ, разработанный в MIT и отмеченный наградой MLSys 2024, защищает важные веса на основе анализа амплитуд активаций. Оба метода требуют небольших калибровочных наборов данных, но не нуждаются в переобучении.
EXL2 — родной формат для ExLlamaV2, оптимизированный под потребительские GPU. Его преемник, EXL3, базируется на технологии QTIP, представленной на NeurIPS 2024. ExLlamaV3 поддерживает квантование KV-кэша и требует CUDA 12.4. Для чипов Apple Silicon используется пакет MLX-LM, сохраняющий квантованные веса в формате safetensors.



