

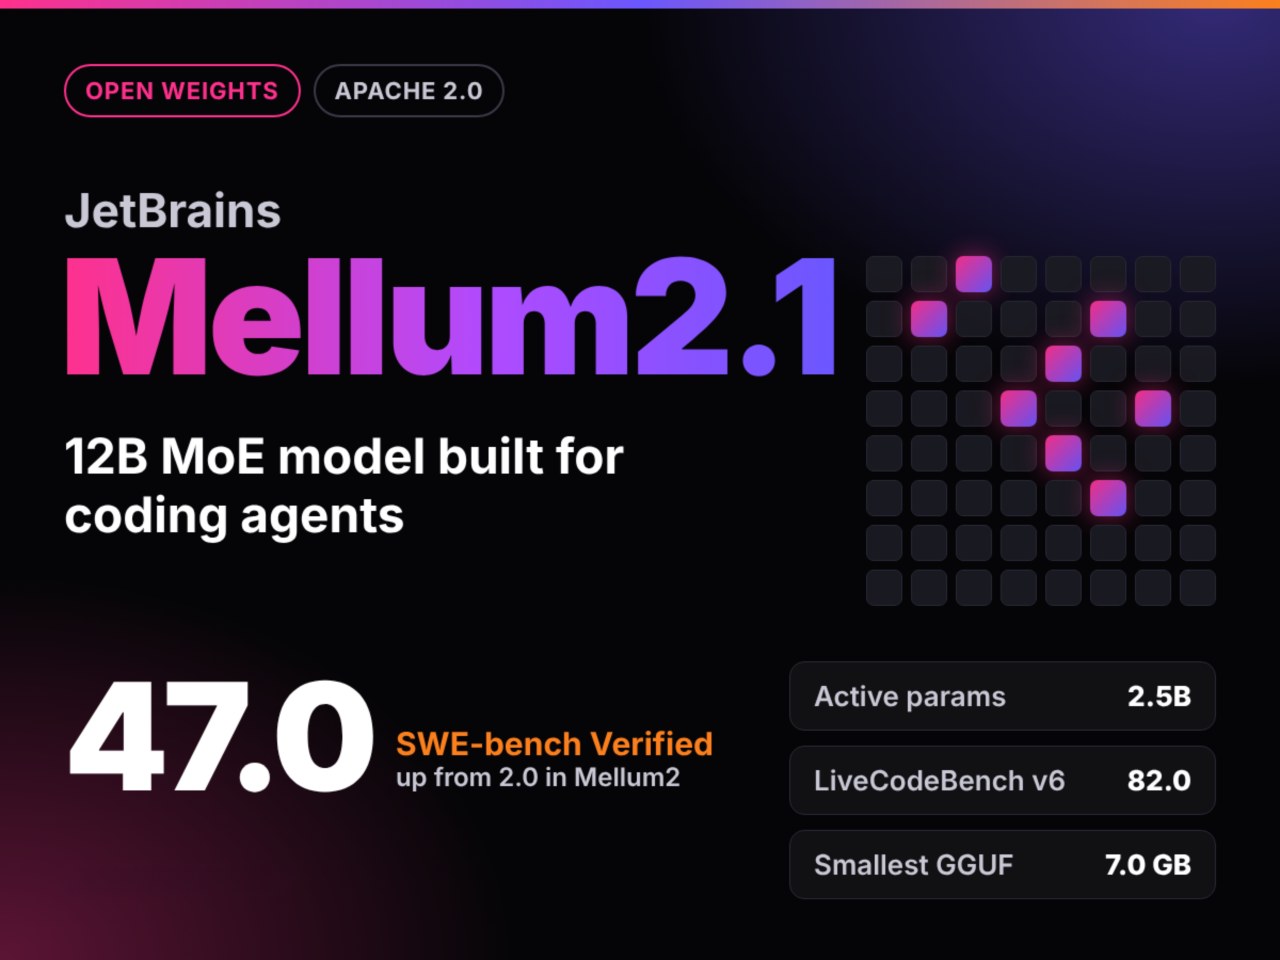
Компания JetBrains представила Mellum2.1-12B-A2.5B-Thinking — открытую модель для кодинг-агентов с архитектурой MoE. Модель содержит 28 слоев и 64 эксперта, активируя 8 из них для каждого токена. Она поддерживает контекстное окно в 131 072 токена и использует механизм grouped-query attention с 32 запросами и 4 KV-головами.
Основная работа над моделью велась на этапе пост-обучения с применением обучения с подкреплением в таких областях, как разработка ПО, математика и программирование. Обучение проходило в миллионах «песочниц» в тысячах сред. Модель сохранила архитектуру предыдущей версии, что позволило сохранить прежнюю скорость работы.
В тестах на агентское кодирование модель показала рост показателей: SWE-bench Verified достигло 47,0, а Terminal-Bench 2.1 — 17,4. В бенчмарках LiveCodeBench v6 и HumanEval+ модель набрала 82,0 и 91,5 балла соответственно. Показатель безопасности HarmBench снизился до 8,5, что свидетельствует о повышении защищенности.
По данным JetBrains, на GPU H200 при высокой нагрузке Mellum2.1 обрабатывает почти в 2 раза больше токенов, чем Qwen3.5-9B. Использование многотокенового предсказания ускоряет выполнение одиночных запросов в 1,6 раза. Модель работает через vLLM, в настоящее время готовятся GGUF-сборки.



