

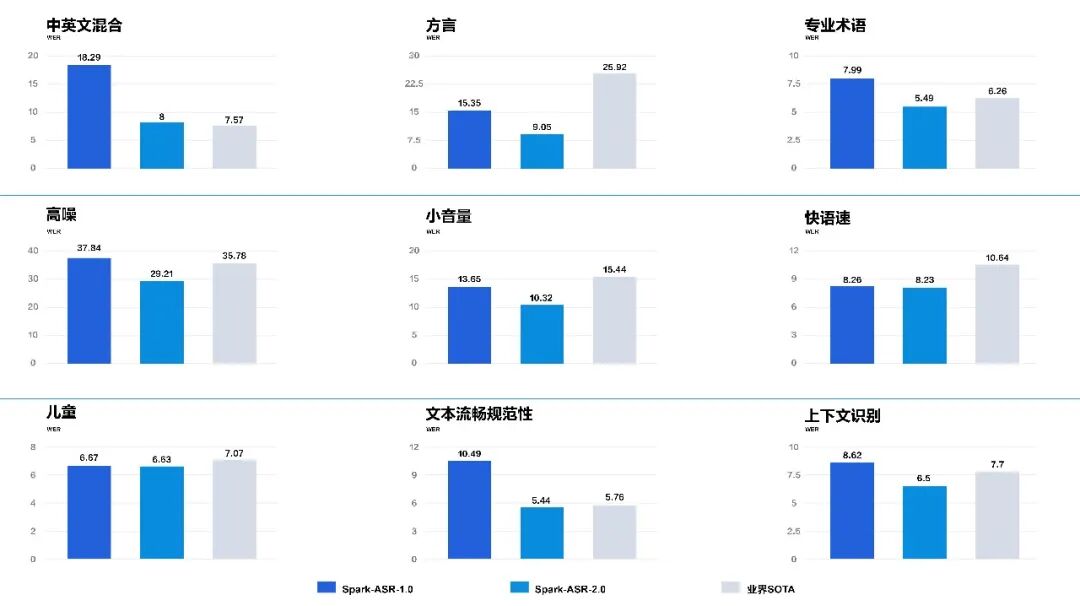
Компания iFlytek представила новую модель распознавания речи Spark-ASR-2.0. Технология использует комбинацию неавторегрессионных методов и усиленной LLM-авторегрессии, а также динамическую интеграцию контекста для повышения точности обработки звука.
Модель демонстрирует улучшенные показатели при работе со смешанной китайско-английской речью, диалектами и в сложных акустических условиях, включая высокий уровень шума, тихий голос и быструю речь. Система также оптимизирует текст для обеспечения его связности.
Затраты на логический вывод Spark-ASR-2.0 увеличились лишь на 10 процентов по сравнению с версией Spark-ASR-1.0. При этом разработчики отмечают значительное снижение частоты ошибок в словах при выполнении основных задач распознавания.
С завтрашнего дня модель начнет внедряться в фирменный метод ввода iFlytek и станет доступна через API на открытой платформе компании. В дальнейшем Spark-ASR-2.0 будет интегрирована в умные очки, офисные планшеты и сервисы транскрибации iFlytek.



