

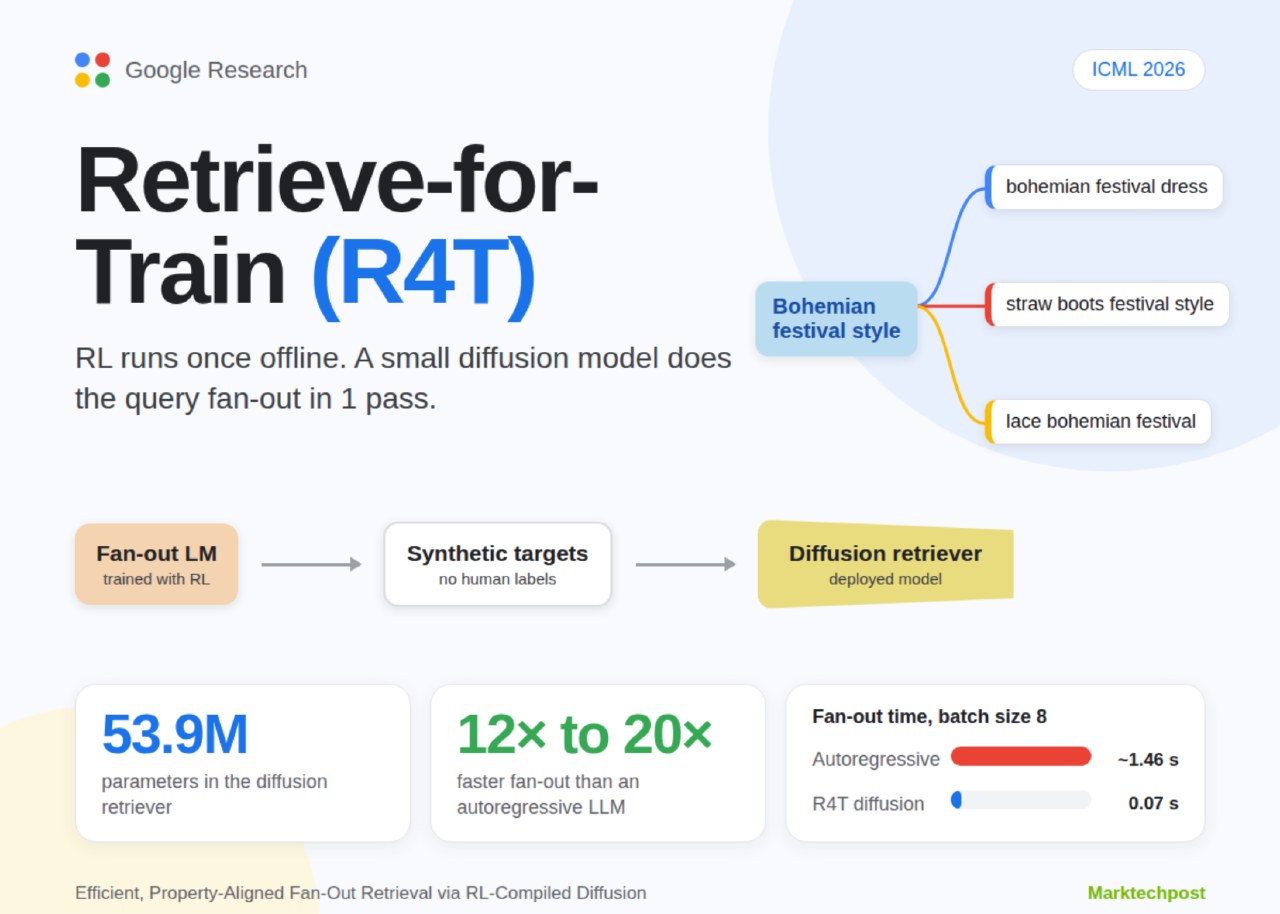
Google Research представила фреймворк Retrieve-for-Train (R4T) для оптимизации процесса разделения запросов на подзапросы. Система использует обучение с подкреплением в офлайн-режиме для настройки компактной диффузионной модели, которая формирует направления поиска за один проход.
Разработка решает проблемы парафрастического коллапса, при котором модели выдают синонимы, и высокой задержки при авторегрессионной генерации. Обучение R4T проходит с использованием алгоритма GRPO и мягкой регуляризации PPO при размере группы 8 и глобальном батче 512.
В ходе экспериментов на наборах данных Polyvore и музыкальных треках модель Gemma3-4B R4T-FOLM показала результат 49,1 балла, превзойдя метод Best-of-N с 40,9 баллами и zero-shot с 38,5 баллами. Диффузионная модель также продемонстрировала более высокие показатели разнообразия результатов.
Технология обеспечивает ускорение работы в 12–20 раз по сравнению с авторегрессионными методами. При размере батча 1024 диффузионная модель выполняет задачу за 4,21 секунды, тогда как стандартный подход требует почти 50 секунд.



