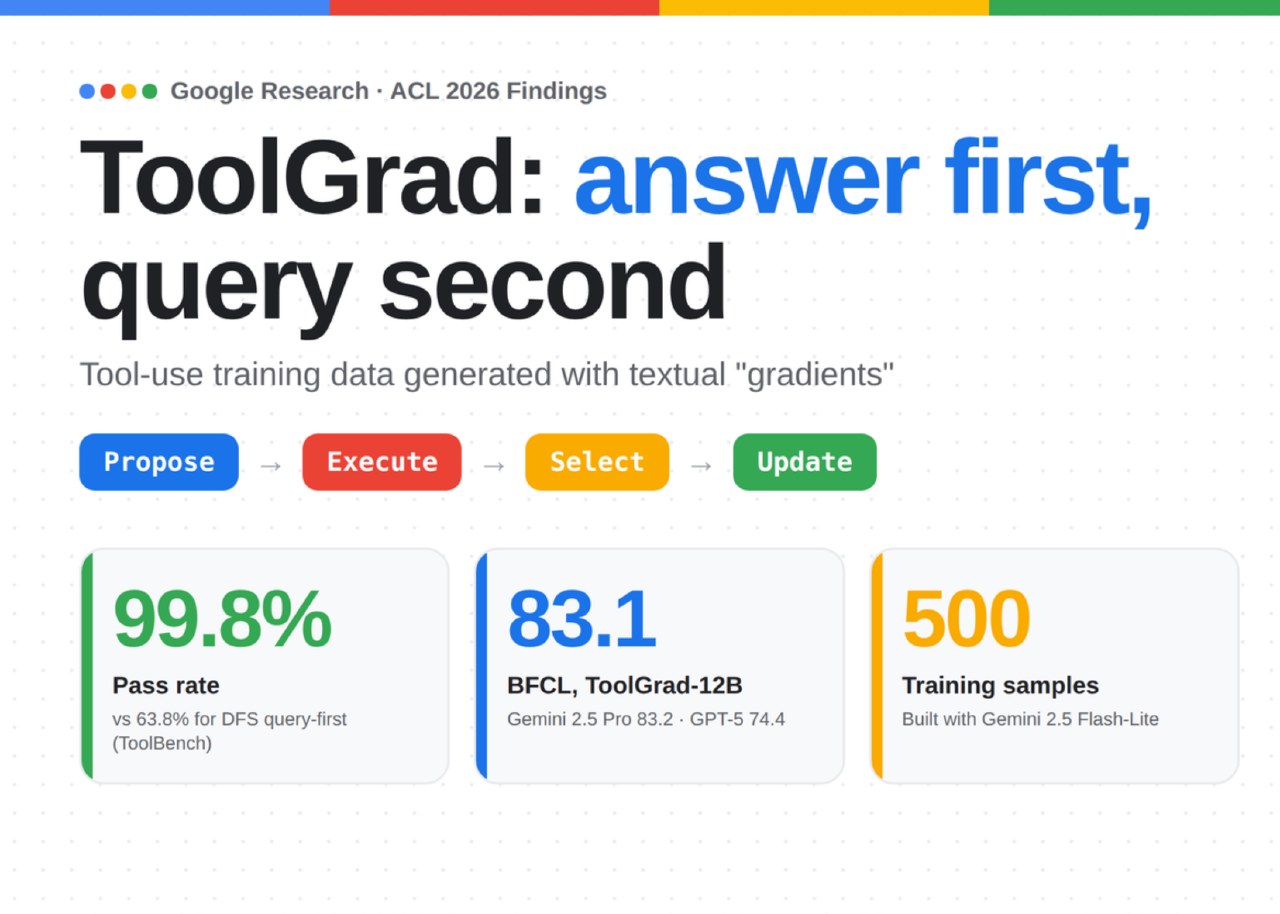
Google Research представила ToolGrad — фреймворк для генерации данных по использованию инструментов, работающий по принципу «сначала ответ». В отличие от методов ToolBench и ToolACE, использующих поиск в глубину, ToolGrad сначала выполняет цепочку API, а затем создает соответствующий запрос пользователя. Это исключает неэффективные затраты ресурсов на неудачные попытки поиска.
Новый подход требует одного вызова LLM для аннотирования цепочки, что гарантирует наличие проверенного рабочего процесса в каждом сэмпле. Система показала 99,8% успешных результатов. Оставшиеся 0,2% неудач связаны с невозможностью получить ответ от выбранных API за 10 итераций. Стандартная конфигурация системы обрабатывает 50 API для каждого рабочего процесса.
Исследователи опубликовали набор данных ToolGrad-500, созданный с помощью Gemini 2.5 Flash-Lite, и использовали его для дообучения моделей Gemma-3 с 1B, 4B и 12B параметров. Модели прошли тестирование на Berkeley Function Calling Leaderboard, продемонстрировав работу с инструментами, которые не входили в обучающую выборку.
Код проекта распространяется по лицензии Apache-2.0. Модели и датасет доступны на платформе Hugging Face, также выпущен пакет PyPI. Скрипты для воспроизведения результатов поддерживают версии BFCL V1 и V2. Для запуска инференса в Docker-контейнере vLLM разработчики использовали графический ускоритель NVIDIA A100 с 40 ГБ памяти.