

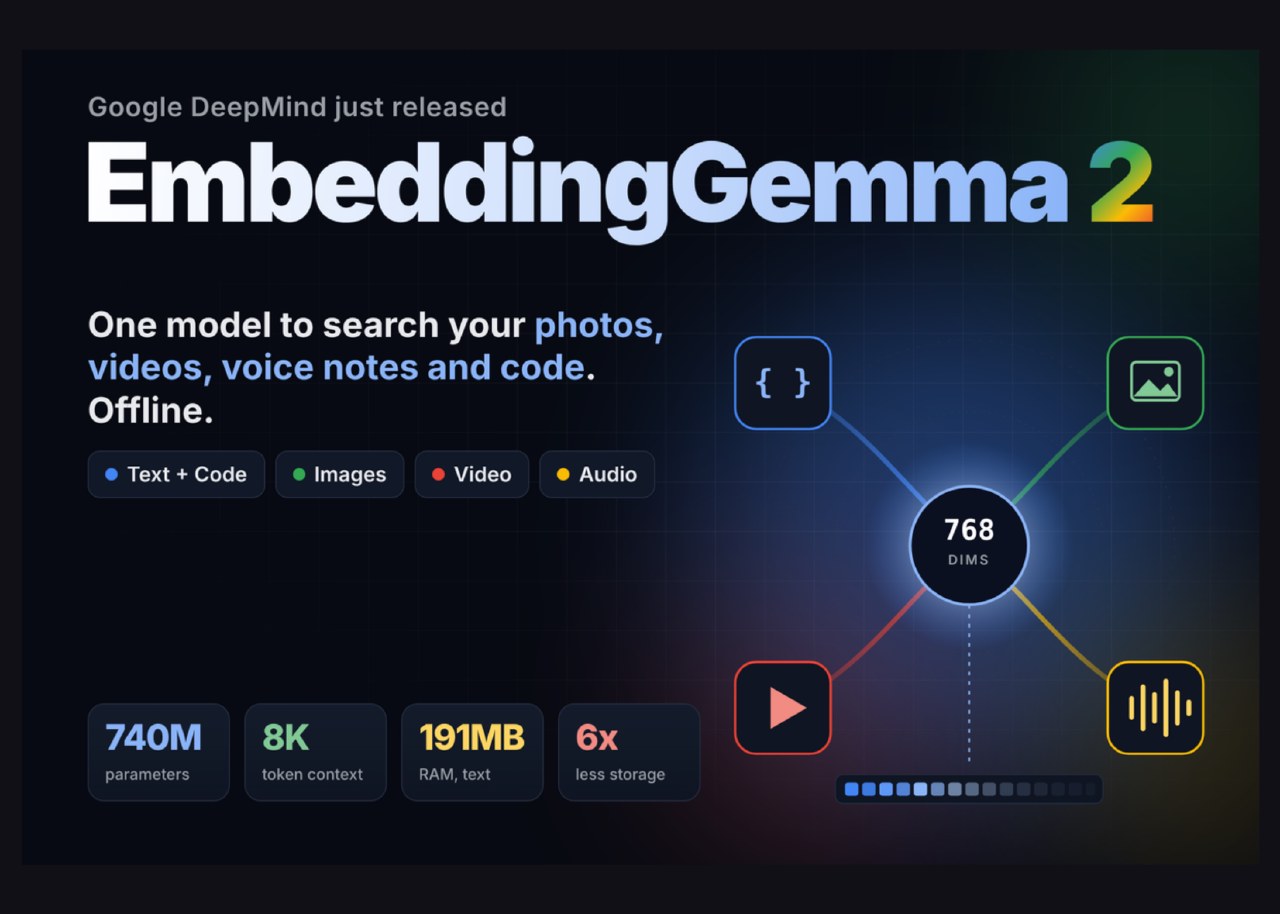
Google DeepMind представила EmbeddingGemma 2 — мультимодальную модель эмбеддингов на архитектуре Gemma 4. Она преобразует текст, изображения, аудио и видео в векторы в едином пространстве. Разработчикам доступны конфигурации от 270 миллионов до 740 миллионов параметров в зависимости от типа используемых данных.
Контекстное окно модели составляет 8 192 токена, что в четыре раза больше, чем у первой версии. Поддержка Matryoshka Representation Learning позволяет сокращать размерность векторов до 512, 256 или 128 единиц для экономии памяти. На GPU MacBook M5 Pro скорость обработки одного изображения составляет 37,3 мс при бюджете в 70 токенов.
Модель оптимизирована для локального запуска. На смартфоне Pixel 11 Pro текстовая версия потребляет около 191 МБ оперативной памяти, а полная мультимодальная конфигурация — 567 МБ. Для сжатия весов до форматов INT4 и INT8 применяется обучение с учетом квантования.
Веса модели уже доступны на платформах Hugging Face и Kaggle. Инструмент поддерживает работу с фреймворками vLLM, SGLang, MLX, llama.cpp и другими. В ближайшие недели ожидается внедрение поддержки ML Kit для Android с ускорением через NPU.



