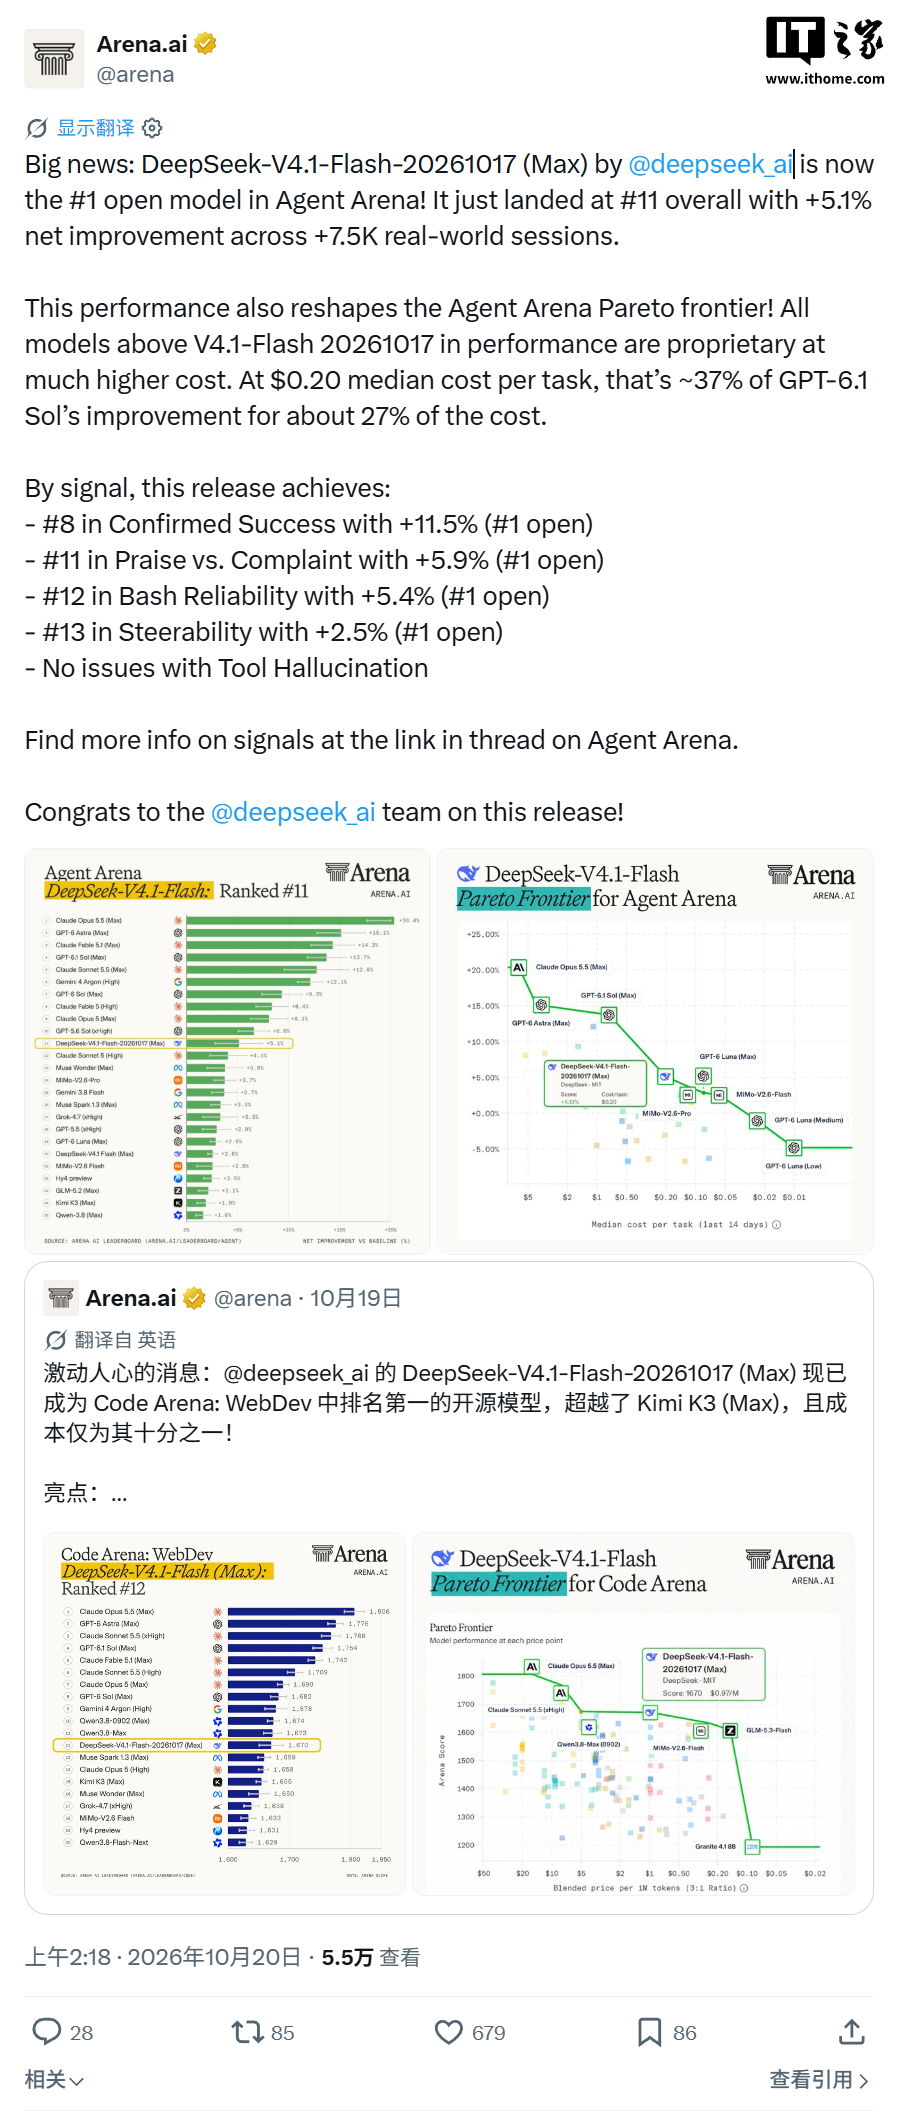
Лаборатория DeepSeek открыла исходный код фреймворка DeepInfer под лицензией Apache-2.0. Инструмент предназначен для запуска собственных моделей компании в продакшене, включая DeepSeek-V4.1-Flash.
Фреймворк включает оптимизации: кастомные ядра, распределенный параллелизм, спекулятивную декодировку и поддержку структурированного вывода. Также реализован параллелизм экспертов для моделей типа mixture-of-experts.
При работе с DeepSeek-V4.1-Flash показатель попаданий во входной кэш составляет 96%. Скорость генерации достигает 230 токенов в секунду, а при выполнении задач по программированию — до 300 токенов в секунду.
Решение оптимизировано для GPU NVIDIA SM100 и NPU Huawei Ascend 950 с упором на офлайн-инференс и высокую пропускную способность. Дополнительно выпущен инструмент deepseek-recipe для токенизации, соответствующий логике официального API.