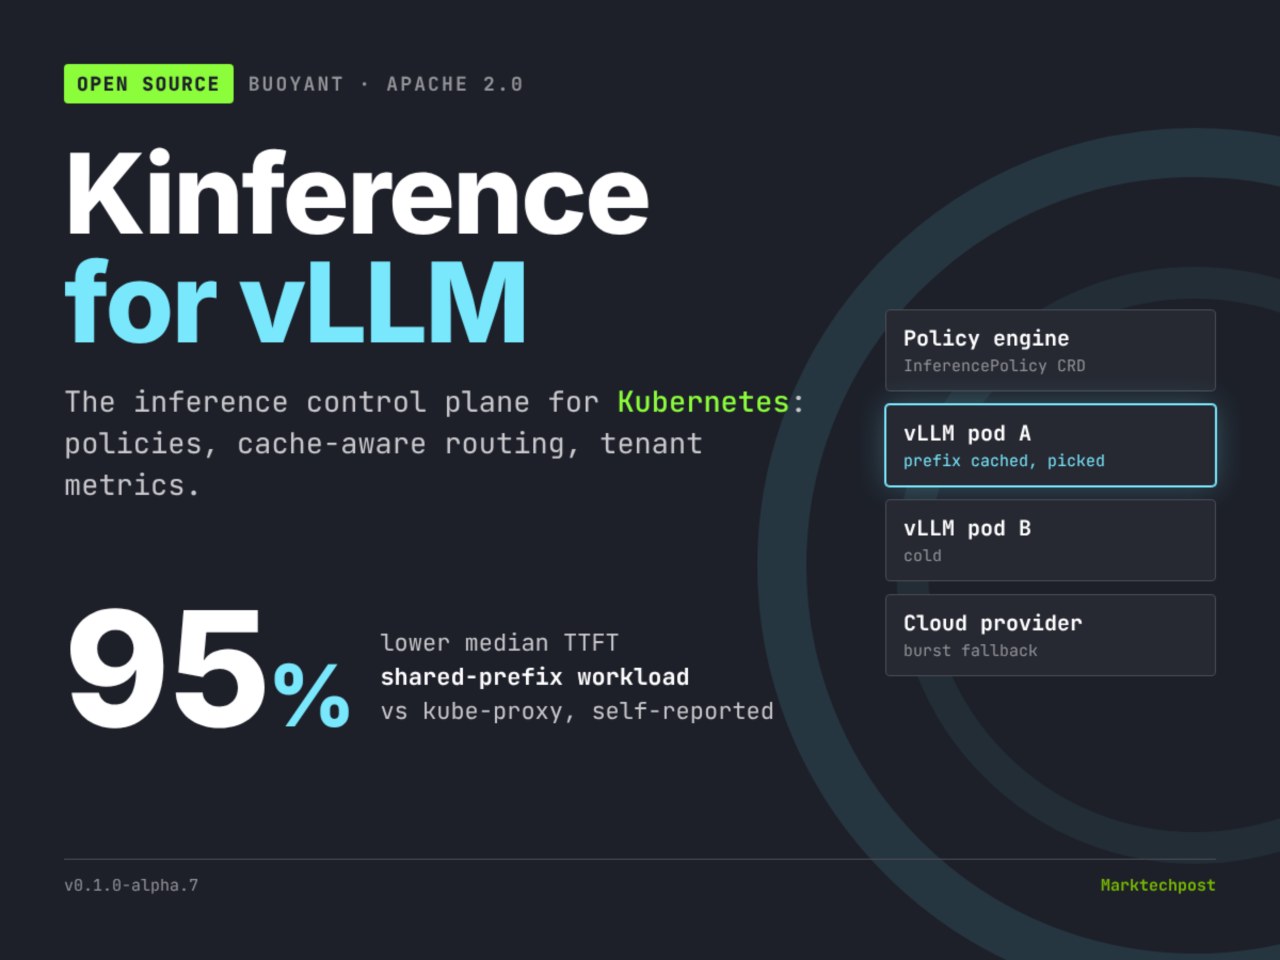
Компания Buoyant представила Kinference — open-source решение для управления выводом моделей в Kubernetes и vLLM. Система разделяет уровни данных и управления: vLLM отвечает за обработку, а Kinference — за маршрутизацию запросов через шлюз и обработчик с gRPC-интерфейсом.
Kinference отслеживает события KV-кэша vLLM и метрики движка, используя библиотеку dynamo-kv-router. Настройка осуществляется через пять CRD, включая политики вывода и пулы. Декларативные правила позволяют фильтровать запросы по арендаторам, моделям и состоянию GPU, а их валидация доступна через CLI-инструмент kinfctl.
В ходе тестов на трех подах vLLM 0.31.0 с GPU L40S и моделью Qwen3.8-27B-FP8 решение показало снижение медианной задержки на 45% для shared-prefix задач по сравнению со стандартной балансировкой Kubernetes. Пиковая пропускная способность при соблюдении SLO выросла до 103 запросов в минуту против 14 у базового ClusterIP.
Инструмент ориентирован на корпоративное управление, включая учет ресурсов арендаторов и политику отказоустойчивости. Установка требует развертывания CRD Gateway API v1.5.1 и Helm-чартов Buoyant. В комплект входят дашборды Grafana и метрики Prometheus для мониторинга задержек и использования токенов.