

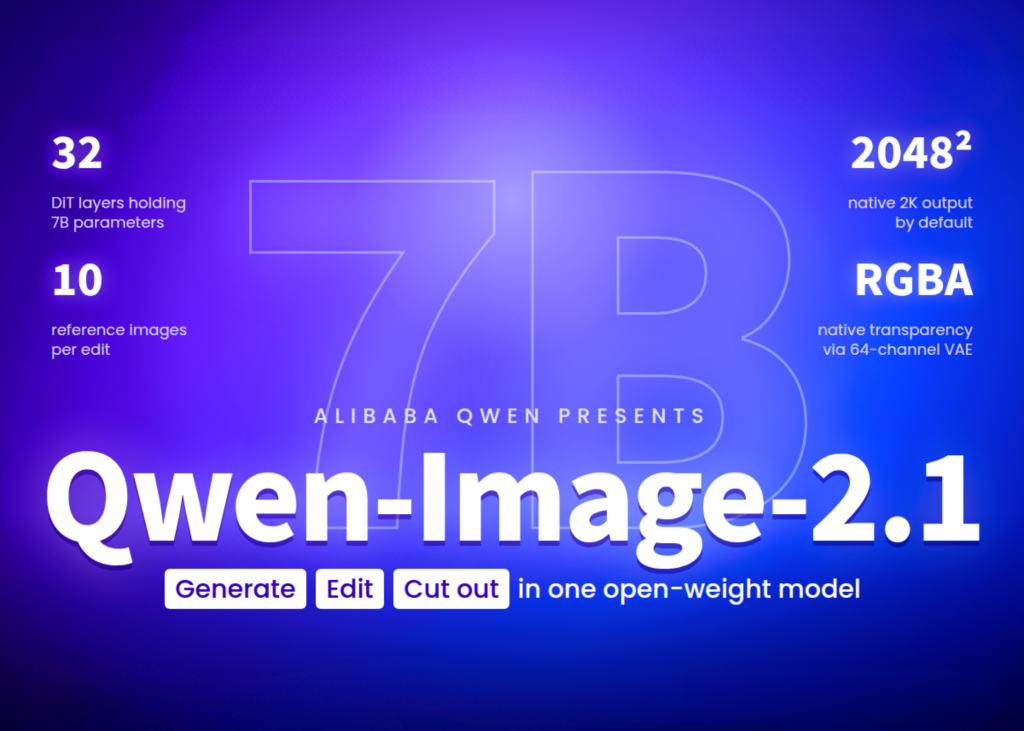
Компания Alibaba представила Qwen-Image-2.1 — модель с открытыми весами для генерации и редактирования изображений. Архитектура включает 7-миллиардный диффузионный трансформер и 8-миллиардный энкодер Qwen3-VL. Модель доступна для исследований, однако для коммерческого использования требуется получение отдельной лицензии.
Технология использует механизм смешанной гранулярности внимания, сочетающий токеновый каузальный маск для текста и чанковый двунаправленный маск для изображений. Это позволяет однократно вычислять текстовые и визуальные данные, повторно используя кэш префикса KV на этапах шумоподавления, что ускоряет обработку при работе с несколькими референсными изображениями.
В рамках внутреннего тестирования на бенчмарке Qwen-Image-Bench модель набрала 60,28 балла. Этот показатель выше, чем у модели FLUX 2 Max 32B с результатом 55,33 и Nano Banana 2.0 с 59,82 балла. При этом шесть закрытых моделей показывают более высокие результаты, лидируя с оценкой 67,01 балла.
Инструментарий поддерживает работу с фреймворками Diffusers, ComfyUI, vLLM-Omni, SGLang и LightX2V. Решение совместимо с графическими процессорами NVIDIA, AMD Radeon через ROCm и 8-чиповыми платформами FlagOS. Также выпущены две модели на базе Qwen3.5-VL 9B для расширения текстовых промптов и выбора соотношения сторон.



