

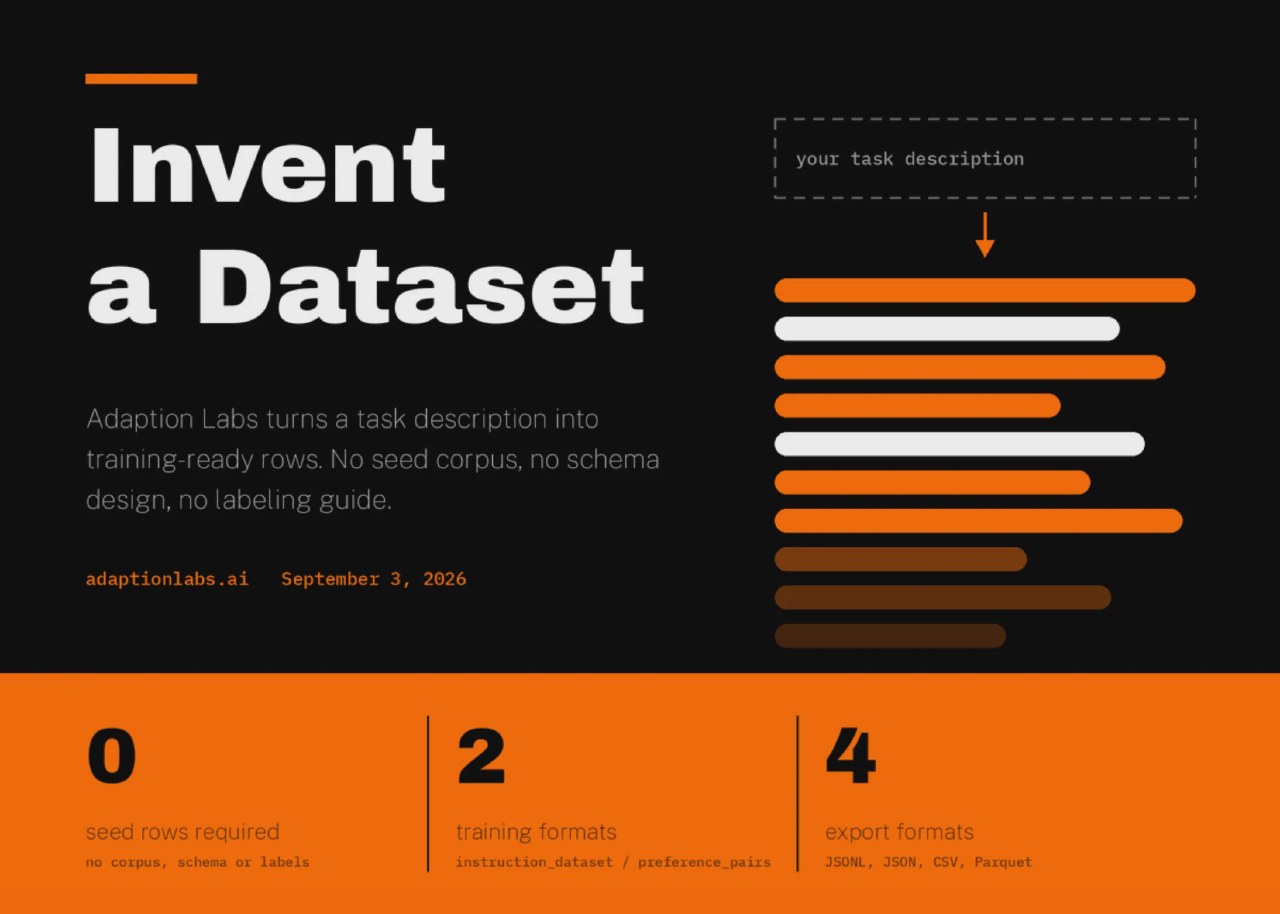
Инструмент позволяет создавать обучающие данные на основе описания задачи, а не на базе существующего корпуса текстов. Сервис доступен в приложении Adaption, через Python SDK и REST API. Результаты выгружаются в форматах JSONL, JSON, CSV или Parquet. Генерация данных происходит на платформе Adaption и требует списания кредитов.
Управление процессом осуществляется с помощью доменных кодов, которые можно получить через datasets.invent_domains. Например, домен medical может быть уточнен поддоменом medical.symptoms_diagnosis. Поддерживаются два формата вывода: instruction_dataset для контролируемого дообучения и preference_pairs для обучения на основе предпочтений (DPO).
Для промышленного использования предусмотрены промпты до 10 000 знаков и ключ идемпотентности до 255 знаков. Функция language_expansion работает в двух режимах: translate для перевода строк и localize для адаптации под конкретные страны. Коэффициент sample_rate от 0,01 до 1 определяет долю строк, подлежащих расширению.
Рабочий процесс интегрирован с AutoScientist, запущенным в мае 2026 года. Этот инструмент оптимизирует данные и рецепты обучения. По данным Adaption, AutoScientist превосходит ручную настройку обучения в среднем на 35%, увеличивая винрейт с 48% до 64%. Результаты получены в восьми вертикалях на датасетах от 5 000 до 100 000 строк с использованием архитектур Together AI.



