

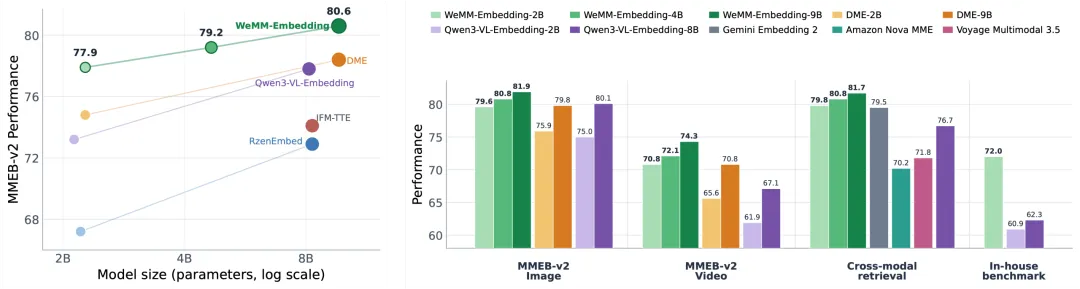
Модель WeMM-Embedding доступна в трех версиях: 2B, 4B и 9B. Она поддерживает работу с текстом, текстом с изображениями, изображениями, видео и визуальными документами, а также с любыми перемешанными мультимодальными данными.
Основная задача модели — обеспечить одновременное понимание текста, картинок и видео, объединяя их в едином семантическом пространстве для последующего сравнения и поиска.
Технология уже масштабно внедрена в сервисы WeChat. Модель используется в поиске по «Моментам», в рекомендациях видеохостинга Channels и официальныхных аккаунтов, а также в WeChat e-commerce.
Система обрабатывает 1 млрд вызовов в день. По данным разработчиков, модель заняла первое место в международном рейтинге MMEB-v2, опередив все ранее представленные открытые и closed-source модели.



